В данном блоге доступно 37 постов на разные темы
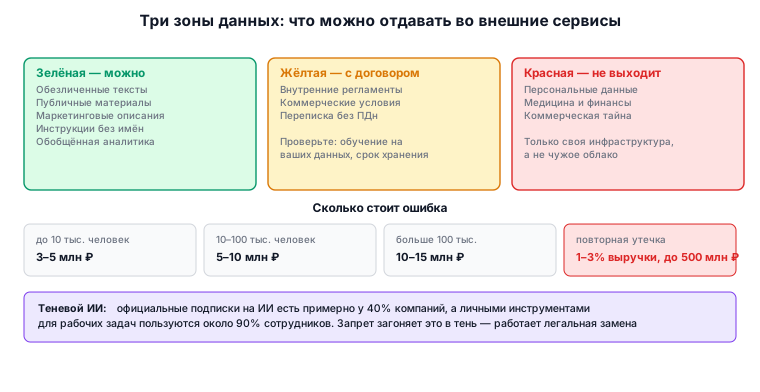
Данные, штрафы и регулирование ИИ: что нужно знать до внедрения
За повторную утечку персональных данных компания может заплатить от 1 до 3 процентов годовой выручки — не менее 20 миллионов и не более 500 миллионов рублей. Это не проект и …
Продвинутый RAG: векторные БД, оценка качества и галлюцинации
Темы 59–62: HyDE, multi-query и graph RAG, HNSW и IVF-PQ в векторных базах, метрики поиска и ответа, борьба с галлюцинациями. 59. Продвинутый RAG Важность на собеседовании: 9/10 █████████░ 🔥🔥🔥 Критично …
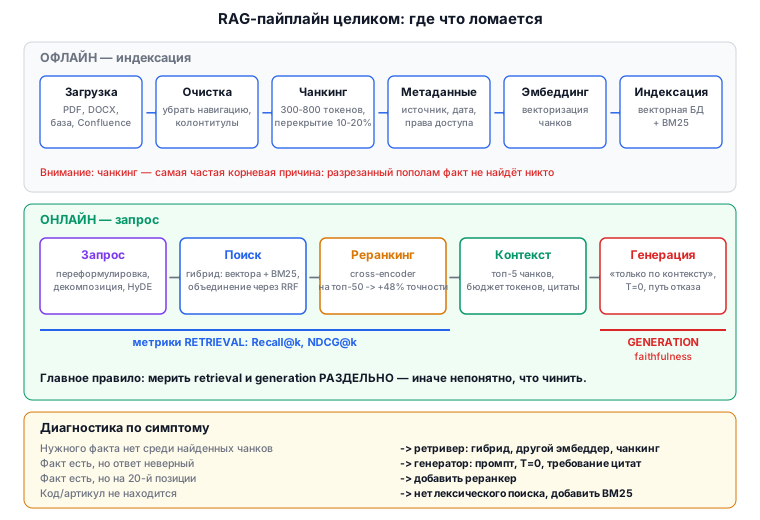
RAG с нуля: промпт-инжиниринг, базовая архитектура и чанкинг
Темы 56–58: техники промптинга, полный RAG-пайплайн и места, где он ломается, гибридный поиск, реранкинг и стратегии чанкинга. Это то, за что вас нанимают. По разборам вакансий и интервью 2026 года …
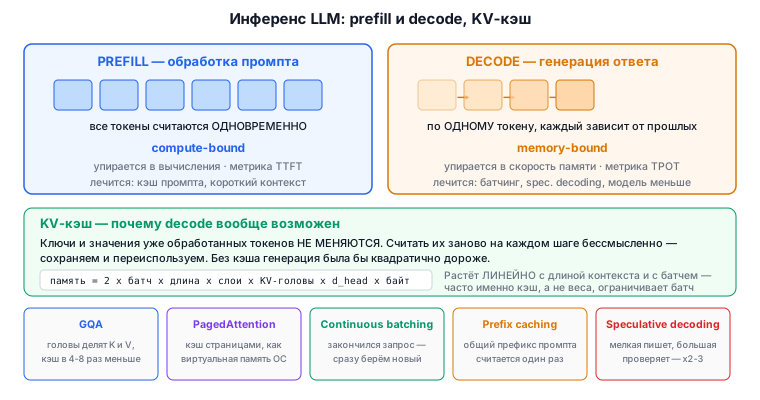
Инференс LLM: KV-кэш, квантизация, LoRA и эмбеддинги
Темы 51–55: prefill и decode, KV-кэш, квантизация, LoRA и QLoRA, длинный контекст, эмбеддинги и реранкеры. 51. KV-кэш и как устроен инференс Важность на собеседовании: 9/10 █████████░ 🔥🔥🔥 Критично для 2026. …
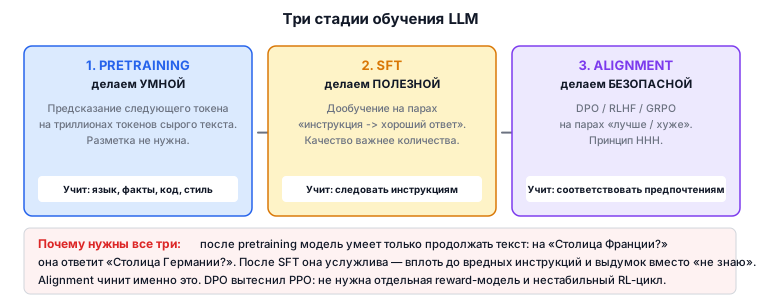
Как обучают LLM: токенизация, предобучение, SFT и alignment
Темы 46–50: BPE и byte-level токенизация, законы масштабирования, обучение следовать инструкциям, RLHF, DPO и GRPO, стратегии декодирования. 46. Токенизация Важность на собеседовании: 9/10 █████████░ 🔥🔥🔥 Критично, и здесь тонет много …
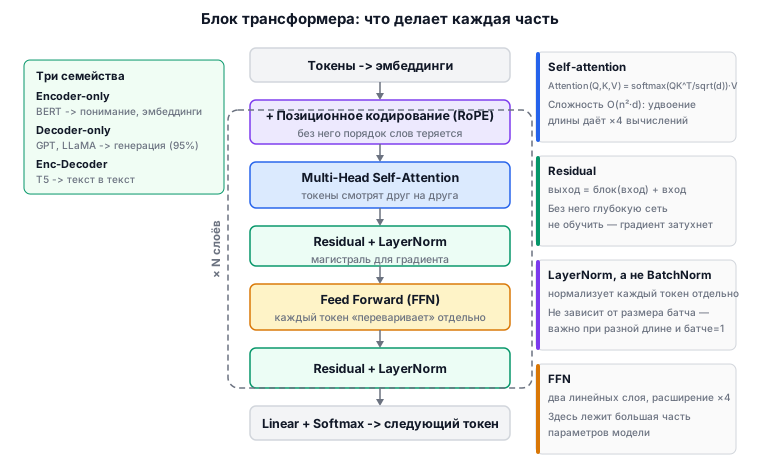
Трансформеры: архитектура, внимание и позиционные кодировки
Темы 40–45: блок трансформера, self-attention через Q, K и V, RoPE и ALiBi, MHA/MQA/GQA и FlashAttention, нормализация, активации и MoE, разница между BERT, GPT и T5. Это ядро собеседования на …