За повторную утечку персональных данных компания может заплатить от 1 до 3 процентов годовой выручки — не менее 20 миллионов и не более 500 миллионов рублей. Это не проект и не обсуждение: оборотные штрафы действуют с 30 мая 2025 года. Разбираем, что изменилось в правилах игры, какие данные нельзя отдавать во внешние ИИ-сервисы и как выстроить работу, чтобы экономия на автоматизации не обернулась штрафом, перекрывающим весь эффект.
Сколько теперь стоит утечка
С мая 2025 года ответственность по 152-ФЗ радикально ужесточилась. Ориентиры, которые стоит знать собственнику:
| Ситуация | Размер штрафа для юрлица |
|---|---|
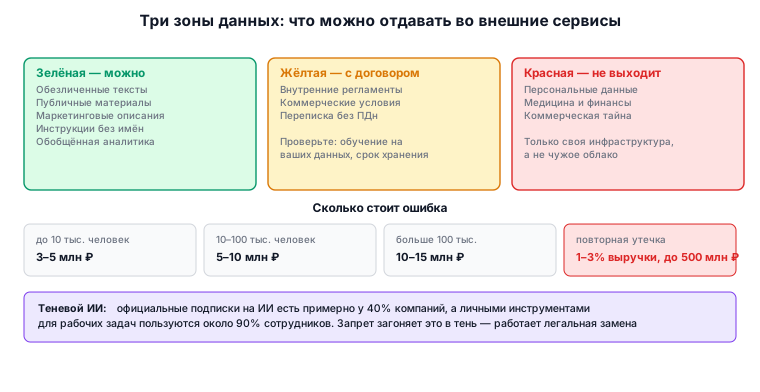
| Утечка данных 1–10 тыс. субъектов | 3–5 млн ₽ |
| Утечка данных 10–100 тыс. субъектов | 5–10 млн ₽ |
| Утечка данных более 100 тыс. субъектов | 10–15 млн ₽ |
| Повторная утечка | Оборотный штраф: 1–3% совокупной выручки за предыдущий год, но не менее 20 млн и не более 500 млн ₽ |
Плюс расширенные полномочия Роскомнадзора и уголовные дела по фактам компрометации баз данных, ставшие регулярной практикой.
Сопоставьте это с экономией от типового ИИ-проекта — сотни тысяч рублей в месяц. Одна утечка перекрывает эффект за несколько лет. Именно поэтому риск утечки данных в исследованиях 2026 года стабильно занимает первое место среди причин отказа от масштабирования ИИ — его называют около 42% компаний.
Простое правило трёх зон
Не нужно быть юристом, чтобы принять базовое решение. Разложите свои данные на три корзины и определите для каждой, куда её можно отправлять.
Зелёная зона — можно отдавать во внешние сервисы. Обезличенные тексты, публичные материалы, маркетинговые описания, инструкции без имён и контактов, обобщённая аналитика без привязки к людям.
Жёлтая зона — только с осознанным решением и договором. Внутренние регламенты, коммерческие условия, переписка без персональных данных. Здесь важно, что написано в договоре с сервисом: используются ли ваши данные для обучения, где они хранятся, сколько времени.
Красная зона — не покидает контур. Персональные данные клиентов и сотрудников, медицинские и финансовые сведения, коммерческая тайна, всё, что защищено требованиями регулятора. Для этой зоны существует только один рабочий вариант: модель работает на вашей инфраструктуре, а не в чужом облаке.
Практический вывод, который многие узнают поздно: обезличивание — не косметика, а инженерная работа. Убрать имя недостаточно, если по остальным полям человек однозначно восстанавливается.
Российская специфика, о которой узнают в последний момент
Три ограничения, влияющие на архитектуру решения ещё до старта проекта:
- Оплатить зарубежные модели напрямую с российского юрлица нельзя. Ни OpenAI, ни Anthropic. Схемы через посредников создают собственные риски — от блокировки доступа посреди рабочего процесса до вопросов о том, где на самом деле оказались ваши данные.
- Требования по локализации персональных данных никто не отменял. Данные российских граждан должны обрабатываться на территории России. Для банков, госсектора и медицины это часто означает, что вариант «отправим в облако» отпадает сразу.
- Импортозамещение перестало быть добровольным. С 1 января 2026 года иностранные средства защиты информации запрещены на объектах критической информационной инфраструктуры, госорганы и компании с госучастием обязаны переходить на отечественное ПО, а полный переход на доверенные программно-аппаратные комплексы должен завершиться к 2030 году. Если ваши заказчики — госкомпании, требования прилетят к вам по цепочке.
Что готовится в регулировании ИИ
18 марта 2026 года Минцифры опубликовало проект федерального закона «Об основах государственного регулирования сфер применения технологий искусственного интеллекта». Планируемый срок вступления в силу — 1 сентября 2027 года. Что в нём важно для бизнеса:
- Обязательная маркировка контента, созданного или существенно изменённого нейросетями, — фото, видео, аудио. Обеспечивать её обязаны владельцы крупных интернет-ресурсов.
- Ответственность соразмерно вине — административная и уголовная. Отвечать будут разработчики, операторы и владельцы ИИ-систем, если они знали или должны были знать о возможности противоправного результата.
Это ещё проект, и формулировки изменятся. Но направление понятно, и два практических вывода можно сделать уже сейчас: во-первых, стоит вести журнал того, где и как в компании применяется ИИ; во-вторых, ссылка «так решила модель» не будет работать как оправдание — ответственность останется на компании.
Теневой ИИ: риск, которого нет в бюджете
Исследование MIT зафиксировало любопытный разрыв: официальные подписки на языковые модели есть примерно у 40% компаний, а около 90% сотрудников используют личные ИИ-инструменты для рабочих задач ежедневно.
Переведите это на свою компанию. Прямо сейчас кто-то из ваших сотрудников, возможно, вставляет в чужой чат фрагмент договора, выгрузку клиентов или текст претензии. Без злого умысла — просто чтобы быстрее сделать работу.
Запрет не работает: он загоняет практику в тень. Работает другое:
- дать легальный инструмент, который решает ту же задачу, — тогда обходить правила незачем;
- написать понятную одностраничную памятку: что можно, что нельзя, куда идти с вопросом;
- объяснить последствия на языке денег, а не «политики безопасности»;
- периодически спрашивать, чем люди пользуются, — без наказания за честный ответ.
Что спросить у подрядчика до подписания
Семь вопросов, которые стоит задать письменно и получить ответы в договоре, а не на словах:
- Где физически хранятся и обрабатываются наши данные?
- Используются ли наши данные для обучения моделей? Как это отключить?
- Сколько времени хранятся наши запросы и ответы, и как их удалить?
- Кто со стороны подрядчика имеет доступ к нашим данным?
- Что происходит с данными при расторжении договора?
- Есть ли решение в реестре отечественного ПО и какие аттестации пройдены?
- Кто отвечает и в каком размере, если утечка произойдёт на стороне подрядчика?
Отсутствие внятного ответа на седьмой вопрос — достаточное основание не подписывать договор. Штраф в любом случае получите вы: перед регулятором отвечает оператор персональных данных, а не его подрядчик.
Минимальный набор мер
Для компании, которая только начинает работать с ИИ, достаточно шести шагов:
- Реестр данных. Что у нас есть, где лежит, кто отвечает, к какой зоне относится.
- Правило зон. Красное не выходит из контура — технически, а не на честном слове.
- Одностраничная памятка сотрудникам. Простым языком, с примерами.
- Легальный инструмент взамен теневого использования.
- Журнал применения ИИ: какие процессы, какие сервисы, какие данные, кто владелец.
- Человек в контуре там, где решение затрагивает деньги, права или обязательства.
Это не превращает компанию в неприступную крепость, но закрывает большинство сценариев, по которым реально штрафуют.
Чек-лист
- Разложены ли наши данные на три зоны и знает ли об этом команда?
- Что технически мешает сотруднику отправить красные данные во внешний сервис?
- Есть ли в договоре с ИИ-подрядчиком пункты про хранение, обучение и удаление данных?
- Кто отвечает за утечку на стороне подрядчика и в каком размере?
- Есть ли у нас легальная альтернатива тому, чем сотрудники пользуются в тени?
- Ведём ли мы журнал: где в компании применяется ИИ и на каких данных?
- Где в наших ИИ-процессах человек принимает окончательное решение?
Источники
- Персональные данные: новые штрафы с 30 мая 2025 года — КонсультантПлюс
- Штрафы за утечку персональных данных 2026: оборотные штрафы, уголовная ответственность
- Штрафы за персональные данные в 2026 году — Data-Sec
- Минцифры разработало проект закона о госрегулировании применения ИИ — КонсультантПлюс
- Регулирование ИИ в России 2026: рамочный закон, сертификация, дипфейки
- Импортозамещение КИИ в 2026: сроки, требования и план перехода
Оставить отзыв
Комментарии
Загрузка комментариев...
★ Оставить отзыв