Форматы и этапы интервью, обязательный минимум знаний, реальные вопросы российских компаний и техника ответа. Плюс карта приоритетов: что учить в первую очередь, а что можно пропустить.
Уровень: Middle → Senior · Рынок: РФ (Яндекс, Сбер, Авито, Т-Банк, VK, Ozon) + международные стартапы
Стек примеров: Python, PyTorch, HuggingFace, LangChain/LlamaIndex, vLLM, векторные БД
Актуальность: август 2026
Формат каждой темы: суть → теория/формула → пример → что спрашивают на собесе → вопросы с ответами.
Читать можно нелинейно: части I–II — база, которую спрашивают всегда; III–V — специализация; VI — инженерия.
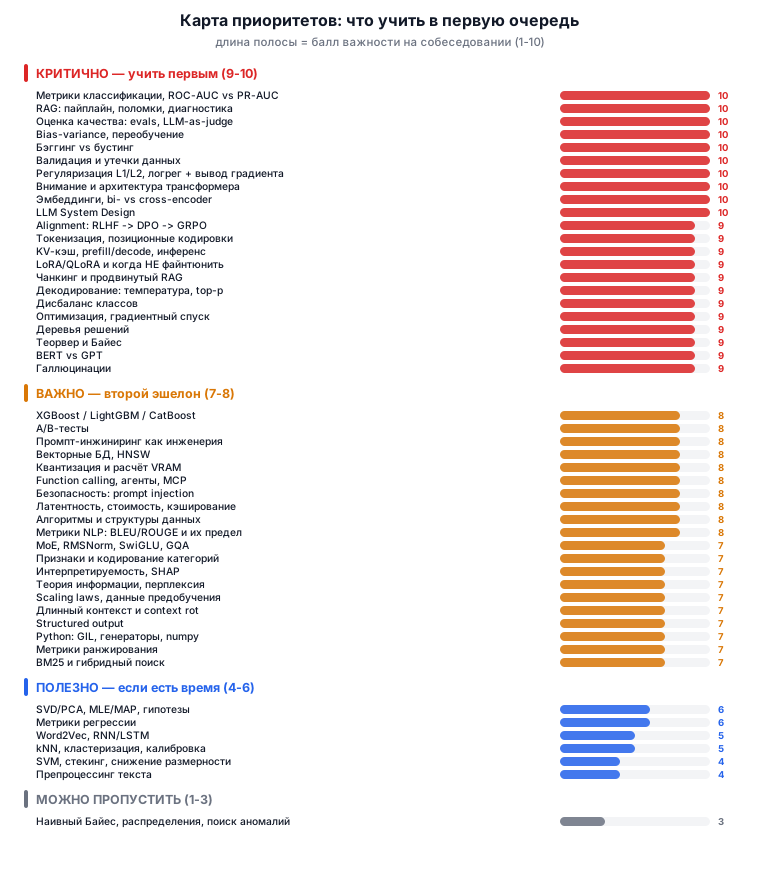
Как читать оценки важности
У каждой темы стоит балл от 1 до 10 — насколько часто и глубоко её спрашивают на собеседованиях, плюс словесный маркер частоты. У больших тем внутри есть разбивка по подтемам со своими баллами: она показывает, что именно учить в первую очередь, если времени мало.
Объём изложения пропорционален баллу. Темы на 9–10 разобраны максимально досконально, с разбором «почему» и типовыми подвохами. Темы на 3–5 даны конспективно — их достаточно понимать, а не знать назубок.
| Балл | Маркер | Что это значит на практике |
|---|---|---|
| 10 | 🔥🔥🔥 Критично | Спросят почти наверняка, и будут копать вглубь с уточняющими вопросами. Не знать — почти гарантированный отказ. |
| 8–9 | 🔥🔥🔥 Критично | Спрашивают на большинстве интервью, часто просят вывести или объяснить механику. Слабый ответ сильно портит впечатление. |
| 6–7 | 🔥🔥 Часто | Всплывает регулярно, но обычно на уровне «объясни и приведи пример». Достаточно уверенно понимать. |
| 4–5 | 🔥 Иногда | Уточняющий вопрос или проверка кругозора. Хватит определения и понимания, когда применимо. |
| 1–3 | ⚪ Редко | Для эрудиции. Не тратьте на это подготовку, если только тема не заявлена в вашем резюме. |
Как пользоваться методичкой для самопроверки. Закройте текст после заголовка темы и ответьте вслух на три вопроса: что это, зачем это нужно, где это ломается. Если по теме на 9–10 баллов вы не отвечаете связно за две минуты — это ваш пробел. Проходите по темам в порядке убывания балла, а не по порядку в оглавлении.
Оглавление
Часть 0. Как устроены собеседования — 0.1 Форматы и этапы · 0.2 Что реально спрашивают
Часть I. Математика (10 тем) — 1 Линейная алгебра · 2 SVD/PCA · 3 Матанализ и градиенты · 4 Вероятность · 5 Распределения · 6 Оценивание, MLE/MAP · 7 Гипотезы и доверительные интервалы · 8 A/B-тесты · 9 Оптимизация · 10 Теория информации
Часть II. Классический ML (24 темы) — 11 Постановка задачи и bias–variance · 12 Метрики классификации · 13 ROC-AUC vs PR-AUC · 14 Метрики регрессии · 15 Метрики ранжирования · 16 Валидация и утечки · 17 Линейная регрессия · 18 Регуляризация · 19 Логистическая регрессия · 20 SVM и ядра · 21 kNN · 22 Naive Bayes · 23 Деревья решений · 24 Бэггинг и Random Forest · 25 Бустинг: AdaBoost и GBM · 26 XGBoost / LightGBM / CatBoost · 27 Стекинг и блендинг · 28 Дисбаланс классов · 29 Признаки и кодирование категорий · 30 Калибровка вероятностей · 31 Кластеризация · 32 Снижение размерности · 33 Поиск аномалий · 34 Интерпретируемость
Часть III. Классический NLP (5 тем) — 35 Препроцессинг · 36 BoW/TF-IDF · 37 Word2Vec/GloVe/FastText · 38 RNN/LSTM/seq2seq · 39 Задачи и метрики NLP
Часть IV. Трансформеры и LLM (16 тем) — 40 Архитектура трансформера · 41 Внимание детально · 42 Позиционные кодировки · 43 MHA/MQA/GQA и FlashAttention · 44 Нормализация, активации, MoE · 45 BERT vs GPT vs T5 · 46 Токенизация · 47 Предобучение и scaling laws · 48 SFT · 49 RLHF, DPO, GRPO · 50 Декодирование · 51 KV-кэш и инференс · 52 Квантизация · 53 LoRA/QLoRA · 54 Длинный контекст · 55 Эмбеддинги и реранкеры
Часть V. LLM-приложения (16 тем) — 56 Промпт-инжиниринг · 57 RAG: базовый · 58 Чанкинг · 59 Продвинутый RAG · 60 Векторные БД и ANN · 61 Оценка RAG · 62 Галлюцинации · 63 Function calling · 64 Агенты и MCP · 65 Structured output · 66 Evals и LLM-as-judge · 67 Наблюдаемость и стоимость · 68 Безопасность · 69 Латентность и throughput · 70 LLM System Design
Часть VI. Инженерия и софт-скиллы (5 тем) — 71 Python на собесе · 72 Алгоритмы: минимум · 73 ML System Design: фреймворк · 74 Поведенческая секция · 75 План подготовки
0.1 Форматы и этапы
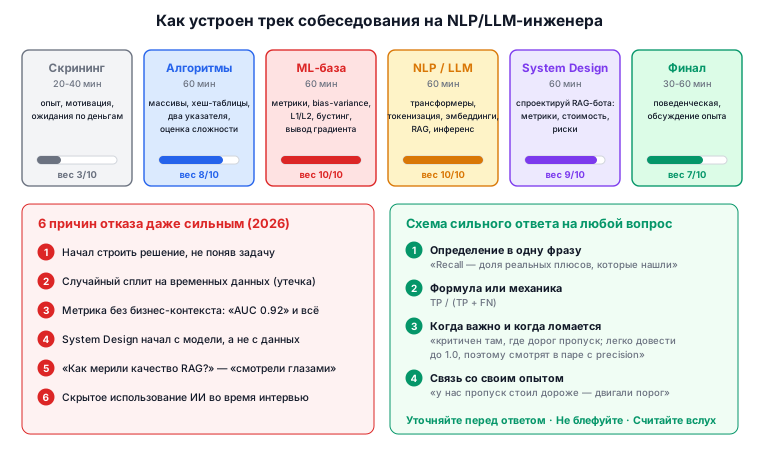
РФ (Яндекс, Сбер, Авито, Т-Банк, VK, Ozon). Типовой трек — 3–5 секций:
- Скрининг с рекрутером (20–40 мин): опыт, мотивация, зарплатные ожидания.
- Алгоритмы / кодинг (60 мин): 1–2 задачи уровня LeetCode Easy/Medium. Массивы, хеш-таблицы, два указателя, строки. Требуют вслух рассуждать про сложность и edge-cases. У Яндекса это отдельная секция «Кодинг».
- ML-база (60 мин): метрики, переобучение, регуляризация, бустинг vs бэггинг, вывод градиента логрега/линрега на доске, теорвер. Здесь режут чаще всего.
- ML Special / доменная секция (60 мин): у Яндекса ветвится на NLP / CV / ASR / RecSys / Classic ML. Для NLP — трансформеры, эмбеддинги, LLM, RAG, ваши проекты.
- ML System Design (60 мин, от middle+): «спроектируй поиск по документам», «спроектируй антифрод», «спроектируй саппорт-бота на LLM».
- Финал с командой / нанимающим менеджером: поведенческая + обсуждение задач команды.
Международные / стартапы. Меньше вывода формул на доске, больше:
- take-home задание (2–6 часов) — часто «сделай RAG над этим корпусом + опиши, как мерил качество»;
- обсуждение реального прод-инцидента: «retrieval вернул мусор — как диагностируешь?»;
- system design с упором на стоимость, латентность, evals, guardrails;
- вопрос-маркер зрелости в 2026: «почему в большинстве лабораторий DPO/GRPO вытеснили классический PPO-RLHF?»
0.2 Что реально спрашивают: обязательный минимум
Знать наизусть (спросят почти гарантированно):
- precision / recall / F1 / ROC-AUC / PR-AUC — определения, когда что ломается;
- bias–variance, переобучение и 5 способов с ним бороться;
- разница бэггинга и бустинга, почему RF снижает variance, а бустинг — bias;
- L1 vs L2: почему L1 зануляет веса;
- как работает self-attention, формула, сложность O(n²·d);
- что такое эмбеддинг, косинусная близость, зачем нормировать;
- RAG-пайплайн от документа до ответа + где он ломается;
- чем LoRA отличается от полного файнтюна и почему это дёшево;
- температура / top-p / top-k при генерации;
- как вы измеряли качество своей LLM-фичи (без ответа «на глаз»).
Уметь на практике:
- написать обучение бустинга на табличке и объяснить каждый гиперпараметр;
- поднять инференс LLM (vLLM / HF
transformers) и оценить, сколько памяти нужно; - собрать RAG: загрузка → чанкинг → эмбеддинги → векторная БД → реранкер → промпт;
- сделать eval-набор из 50–200 примеров и посчитать метрики;
- прикинуть стоимость: токены × цена, где включить кэширование.
Красные флаги для интервьюера: «использую GPT/Claude, но качество не мерил», «RAG — это просто база + промпт», «accuracy 0.99» на дисбалансе 1:100, отсутствие валидации по времени в задаче с временными рядами.
0.3 Реальные вопросы из реальных компаний
Собрано из публичных разборов собеседований и баз вопросов (Exponent, Хабр, ITMO AI, karpov.courses):
| Вопрос | Где спрашивали |
|---|---|
| «Объясни градиентный спуск» | OpenAI |
| «Линейная vs логистическая регрессия» | |
| «Что такое переобучение и как его избежать» | |
| «Спроектируй систему батчинга инференса для одной GPU» | Anthropic |
| «Как ты оцениваешь качество LLM?» | Snap |
| «Спроектируй фреймворк оценки для ранжирования рекламы» | Meta |
| «Batch normalization — зачем и как» | Apple |
| «Функции активации, затухающий градиент» | |
| «Чем случайный лес отличается от градиентного бустинга» | Яндекс, Сбер, Авито (типовой) |
| «Выведи градиент логистической регрессии» | Яндекс, Сбер (типовой) |
| «L1 vs L2 регуляризация» | почти все РФ-компании |
| «Найди пару чисел с заданной суммой» (кодинг) | Яндекс |
Дополнительная секция, о которой часто забывают: code review. В части компаний дают готовый код (иногда — реализацию трансформера или обучающий цикл) и просят найти и исправить ошибки. Типовые закладки: model.eval() не вызван перед валидацией, optimizer.zero_grad() пропущен, маска внимания применена не к тем осям, нормализация посчитана по всему датасету до сплита (утечка), softmax по неверной размерности, loss усредняется неправильно при разных длинах последовательностей.
Секция «обсуждение опыта». Разбирают ваш проект вглубь: откуда данные, как размечали, как валидировали, как выкатывали, что сломалось. Готовьте 2–3 проекта по схеме: задача → метрика → бейзлайн → что делали → результат в бизнес-величинах → что пошло не так.
0.4 Как готовиться: ресурсы
Текстовые:
- Хабр: «Фундаментальные вопросы по ML/DL, часть 1 и 2» (линейки, Байес, регуляризация, SVD/PCA, bias-variance, деревья, бустинг) — формат «Вопрос → Краткий ответ → Разбор → Код».
- GitHub
epishchik/ML-Interview— вопросы с реальных собеседований на ML Engineer (ML-база, метрики, Python, GIL, SQL, CV/трансформеры). - GitHub
KalyanKS-NLP/LLM-Interview-Questions-and-Answers-Hub— 100+ вопросов по LLM с ответами. - GitHub
Devinterview-io/llms-interview-questionsиensemble-learning-interview-questions. - Yandex Education: «Секция на проверку базовых технических навыков ML-инженеров» — официальное описание того, что спрашивают.
- DataCamp: «Top 36 LLM Interview Questions», «Top 30 RAG Interview Questions», «MCP Interview Questions».
YouTube (разборы и мок-собеседования):
- karpov.courses — серия «Junior ML-инженер | Собеседование» (несколько выпусков): показывает реальный формат ML-секции целиком, включая то, как интервьюер докапывается уточняющими вопросами.
- «Mock-собеседование на позицию Junior ML Engineer» — собеседует ML Engineer из Авито; хорошо видно, какие ответы считаются достаточными, а какие — поверхностными.
- Плейлист «Собеседования ML» — подборка секций по Python, ML, CS, NLP.
- Edureka «Top 30 LLM Interview Questions and Answers (2026)» и «Top 25 AI/ML Engineer Interview Questions (2026)» — англоязычные, для международного формата.
Как использовать видео правильно: не смотреть пассивно. Ставьте паузу на каждом вопросе, отвечайте вслух сами, потом сравнивайте. Записывайте себя на диктофон — на реальном собесе главная проблема не знание, а сбивчивая речь.
0.5 Как отвечать: техника
Формат ответа, который читается как «сеньорный», на любом техническом вопросе:
- Определение в одну фразу. «Recall — доля реальных положительных, которые модель нашла.»
- Формула или механика.
TP/(TP+FN). - Когда это важно и когда ломается. «Критично там, где пропуск дорог: фрод, медицина. Recall легко довести до 1.0, предсказывая всё положительным — поэтому его смотрят только в паре с precision.»
- Связь с практикой. «У нас в задаче X пропуск стоил дороже ложной тревоги, поэтому порог двигали в сторону recall и следили за нагрузкой на операторов.»
Три правила:
- Уточняйте перед ответом. На открытых вопросах («как бы вы решали...») первые 2–3 минуты — вопросы о задаче, а не решение. Прыжок сразу в архитектуру — маркер джуна и одна из главных причин отказов в 2026 году.
- Не блефуйте. «Не сталкивался, но рассуждал бы так: …» — сильный ответ. Придуманный факт, разваливающийся на первом уточнении, — провал секции.
- Считайте вслух. Порядки величин (сколько ГБ памяти, сколько токенов, сколько запросов в секунду) ценятся выше точных цифр.
Часть 1 из 17 конспекта для подготовки к собеседованиям на NLP/LLM-разработчика. Остальные части — в разделе «Собесы».
Оставить отзыв
Комментарии
Загрузка комментариев...
★ Оставить отзыв