Темы 23–27: деревья решений, бэггинг и Random Forest, AdaBoost и градиентный бустинг, чем отличаются XGBoost, LightGBM и CatBoost, стекинг и блендинг.
23. Деревья решений
Важность на собеседовании: 9/10
█████████░🔥🔥🔥 Критично. База для понимания RF и бустинга, спрашивают почти всегда. Копают средне-глубоко: как выбирается сплит, критерии, почему переобучаются, как обрезать. Важность признаков в деревьях — популярный уточняющий вопрос с подвохом.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Как выбирается сплит (Джини / энтропия) | 9/10 |
| Почему переобучаются и чем ограничивают | 9/10 |
| Смещённость feature_importances_ | 8/10 |
| Не нужно масштабирование, не экстраполируют | 7/10 |
| Пень как слабый ученик | 6/10 |
Механика. Рекурсивно разбиваем выборку по условию признак ≤ порог, выбирая разбиение, максимально «очищающее» узлы.
Критерии для классификации:
- Джини:
G = 1 − Σpᵢ². Интерпретация: вероятность ошибки при случайном угадывании метки согласно распределению в узле. - Энтропия:
H = −Σpᵢ log pᵢ. Прирост информации =H(родитель) − Σ(|дети|/|родитель|)·H(ребёнок).
На практике различие между ними невелико; Джини быстрее (нет логарифма) и поэтому дефолт в sklearn. Спрашивают: обе достигают максимума при равномерном распределении классов и нуля — при чистом узле.
Для регрессии: минимизация дисперсии (MSE) в узлах; предсказание = среднее по листу.
Почему деревья переобучаются. Ничем не ограниченное дерево вырастет до листьев с одним объектом — идеальный train, никакого обобщения. Ограничители: max_depth, min_samples_leaf, min_samples_split, max_leaf_nodes, ccp_alpha (cost-complexity pruning — обрезка снизу вверх с штрафом за число листьев).
Сильные стороны: не нужно масштабирование (сплиты по порядку значений), работают с нелинейностями и взаимодействиями из коробки, интерпретируемы, умеют обрабатывать пропуски (в CART/CatBoost/LightGBM).
Слабые стороны: высокая нестабильность (сдвиг нескольких точек меняет всё дерево), не умеют экстраполировать за пределы диапазона обучения (для регрессии это важно), склонность к прямоугольным границам.
Ловушка про важность признаков. Встроенная feature_importances_ (mean decrease in impurity) смещена в пользу признаков с большим числом уникальных значений — непрерывные и высококардинальные категории получают завышенную важность просто потому, что дают больше вариантов разбиения. Корректнее — permutation importance на отложенной выборке или SHAP. Знание этой ловушки заметно поднимает оценку.
Вопрос: Дерево глубины 1 (пень) — что это и зачем? — Разбиение по одному признаку. Как самостоятельная модель бесполезно (высокий bias), но это классический «слабый ученик» для AdaBoost: бустинг из пней даёт сильную модель, при этом каждый шаг добавляет только один признак — модель растёт контролируемо.
24. Бэггинг и Random Forest
Важность на собеседовании: 10/10
██████████🔥🔥🔥 Критично. «Чем случайный лес отличается от градиентного бустинга» — один из самых частых вопросов на РФ-собесах вообще. Копают глубоко: механика бэггинга, зачем случайные признаки, OOB, почему снижается именно variance. Разжёвано подробно.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Чем RF отличается от бустинга | 10/10 |
| Почему бэггинг снижает variance | 10/10 |
| Зачем случайный выбор признаков (декорреляция) | 9/10 |
| Почему деревья в RF глубокие | 8/10 |
| OOB-оценка и число 36.8% | 7/10 |
| Может ли RF переобучиться | 7/10 |
Бэггинг (Bootstrap Aggregating):
- Из выборки размера n делаем B бутстрэп-выборок — сэмплируем n объектов с возвращением.
- Обучаем модель на каждой независимо (можно параллельно).
- Усредняем предсказания (регрессия) или голосуем (классификация).
Почему это снижает variance — математика. Для B независимых моделей с дисперсией σ² дисперсия среднего равна σ²/B. Но деревья на бутстрэп-выборках коррелированы, и точная формула:
Var(среднее) = ρσ² + (1−ρ)σ²/B
где ρ — попарная корреляция моделей. При B→∞ второе слагаемое исчезает, но остаётся ρσ². Вывод: чтобы усреднение работало хорошо, модели нужно ДЕКОРРЕЛИРОВАТЬ. Это и есть главная идея следующего шага.
Random Forest = бэггинг + случайность признаков. В каждом узле каждого дерева рассматривается не все признаки, а случайное подмножество размера max_features (классика: √d для классификации, d/3 для регрессии). Это снижает ρ — если есть один очень сильный признак, без этого приёма все деревья начали бы с него и оказались почти одинаковыми.
Почему деревья в RF глубокие. Бэггинг лечит variance, но не bias. Значит базовая модель должна быть низкосмещённой — то есть глубокой и переобученной. Обратная логика по сравнению с бустингом, где деревья намеренно слабые.
OOB-оценка (out-of-bag). При бутстрэпе каждое дерево не видит примерно 1/e ≈ 36.8% объектов (вероятность не быть выбранным ни разу: (1−1/n)ⁿ → e⁻¹). Их можно использовать как встроенную валидацию — почти бесплатная замена кросс-валидации. Знание числа 36.8% и откуда оно берётся ценится.
Гиперпараметры: n_estimators (больше — всегда не хуже, только дороже; RF не переобучается с ростом числа деревьев), max_features (главный рычаг), max_depth/min_samples_leaf (обычно не ограничивают), class_weight.
Extra Trees (Extremely Randomized Trees) — идут дальше: пороги разбиения выбираются случайно, а не оптимально. Ещё сильнее декорреляция, ещё ниже variance, чуть выше bias. Быстрее обучается.
Вопрос: Может ли Random Forest переобучиться? — С ростом числа деревьев — нет, качество выходит на плато. Но переобучиться может из-за самих данных: при сильном шуме или очень малой выборке глубокие деревья запомнят шум, и усреднение не спасёт. Также RF плохо работает при очень высокой размерности с редкими информативными признаками — случайный выбор √d признаков почти никогда не попадает на нужный.
25. Бустинг: AdaBoost и градиентный
Важность на собеседовании: 10/10
██████████🔥🔥🔥 Критично. Второй по важности после метрик. Спрашивают всегда, копают глубоко: последовательность vs параллельность, что такое «остатки», почему деревья неглубокие, как связан learning rate и число деревьев. Обязательно уметь объяснить разницу с бэггингом в двух предложениях.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Механика градиентного бустинга (антиградиент) | 10/10 |
| Бэггинг vs бустинг — таблица различий | 10/10 |
| Почему деревья неглубокие | 9/10 |
| Связка learning rate и числа деревьев | 9/10 |
| Ранняя остановка | 9/10 |
| AdaBoost и веса объектов | 6/10 |
Общая идея. Модели строятся последовательно, каждая следующая исправляет ошибки предыдущих. Итог — взвешенная сумма слабых моделей.
AdaBoost (1995). Работает через веса объектов: после каждой итерации неверно классифицированные объекты получают больший вес, и следующая модель концентрируется на них. Вклад каждой модели в ансамбль пропорционален её качеству. Чувствителен к выбросам — им постоянно наращивается вес.
Градиентный бустинг (GBM) — обобщение. Вместо весов работает с градиентами функции потерь:
F₀(x)= константа (например, среднее по таргету).- На шаге m считаем псевдо-остатки — антиградиент потери по текущему предсказанию:
rᵢ = −∂L(yᵢ, F(xᵢ))/∂F(xᵢ). - Обучаем новое дерево
h_mпредсказывать эти остатки. F_m = F_{m−1} + η·h_m, гдеη— learning rate (shrinkage).
Для MSE псевдо-остаток равен обычному остатку y − ŷ — отсюда интуиция «каждое дерево доучивает то, что не доучили предыдущие». Для других потерь (логистической, Huber, квантильной) это уже не буквальные остатки, а именно градиенты — поэтому метод работает с любой дифференцируемой потерей. Это ключевая мысль: градиентный бустинг — это градиентный спуск в пространстве функций.
Почему деревья слабые (depth 3–8). Бустинг снижает bias за счёт последовательного наращивания. Если базовая модель уже сильная, ансамбль быстро переобучится и потеряет смысл. Глубина в бустинге примерно соответствует «максимальному порядку взаимодействий признаков»: depth=1 — аддитивная модель без взаимодействий, depth=3 — до трёхфакторных взаимодействий.
Learning rate и число деревьев связаны обратно. Меньше η → нужно больше деревьев, но качество обычно выше и модель устойчивее. Практика: η ∈ [0.01, 0.1], n_estimators подбирается ранней остановкой по валидации, а не фиксируется.
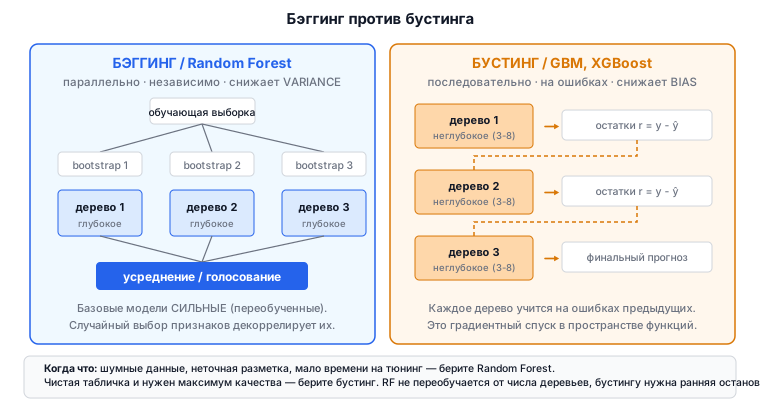
Бэггинг vs бустинг — короткий ответ, который от вас ждут:
| Бэггинг / RF | Бустинг | |
|---|---|---|
| Обучение | Параллельно, независимо | Последовательно, каждая на ошибках предыдущих |
| Базовые модели | Сильные (глубокие деревья) | Слабые (неглубокие) |
| Что снижает | Variance | Bias |
| Переобучение с ростом моделей | Практически нет | Да, нужна ранняя остановка |
| Чувствительность к шуму и выбросам | Низкая | Высокая |
| Настройка | Простая, работает «из коробки» | Требует тюнинга |
| Когда лучше | Шумные данные, мало времени на тюнинг, нужен быстрый надёжный бейзлайн | Нужен максимум качества на табличке, есть время и чистые данные |
Стохастический градиентный бустинг: subsample < 1 (обучать каждое дерево на случайной части выборки) и colsample (на части признаков) — добавляют регуляризацию и ускоряют обучение.
Вопрос: Когда Random Forest победит градиентный бустинг? — При сильно зашумлённых данных и неточной разметке (бустинг будет упорно доучивать шум), при очень малой выборке, при жёстком дефиците времени на подбор гиперпараметров, и когда нужна робастность важнее последних процентов качества. На чистых табличных данных с достаточным объёмом бустинг почти всегда впереди.
26. XGBoost, LightGBM, CatBoost
Важность на собеседовании: 8/10
████████░░🔥🔥 Часто, а для табличных ролей 🔥🔥🔥. Спрашивают «чем отличаются и что бы выбрали», уточняют про категориальные признаки и скорость. Средняя глубина: механику ordered boosting и GOSS знать желательно, выводить не просят.
XGBoost. Первая массовая «инженерная» реализация. Ключевое: регуляризация в целевой функции (λ на L2 весов листьев, γ на число листьев), второй порядок разложения потери (использует гессиан, а не только градиент), level-wise рост дерева (по уровням), обработка пропусков через выученное «направление по умолчанию» для NaN.
LightGBM. Оптимизирован на скорость и большие данные:
- Histogram-based: непрерывные признаки бинируются (обычно 255 бинов) → поиск сплита работает по гистограмме, а не по всем значениям. Радикальное ускорение.
- Leaf-wise рост: расширяется тот лист, который даёт максимальное снижение потери, а не весь уровень. Быстрее сходится, но сильнее переобучается — поэтому обязателен
num_leaves(и он должен быть заметно меньше2^max_depth) иmin_data_in_leaf. - GOSS (Gradient-based One-Side Sampling): сохраняет объекты с большими градиентами и подсэмплирует те, что с малыми.
- EFB (Exclusive Feature Bundling): склеивает взаимно исключающие разреженные признаки (например, one-hot) в один → меньше размерность.
CatBoost (Яндекс). Оптимизирован под категориальные признаки и устойчивость:
- Ordered target statistics: категория кодируется средним таргетом, посчитанным только по предшествующим в случайной перестановке объектам. Это устраняет утечку target-энкодинга по построению, без ручных фолдов.
- Ordered boosting: та же идея применена к самому бустингу, борется со сдвигом предсказания (prediction shift), который возникает из-за того, что остатки считаются на тех же данных, где обучались.
- Симметричные (oblivious) деревья: на каждом уровне одно и то же условие для всех узлов. Сильная регуляризация + очень быстрый инференс (предсказание сводится к битовым операциям).
- Лучшие результаты «из коробки» без тюнинга — важное практическое преимущество.
Как выбирать (ответ на собесе):
| Ситуация | Выбор |
|---|---|
| Много категориальных признаков высокой кардинальности | CatBoost |
| Очень большой датасет, важна скорость обучения | LightGBM |
| Нужна зрелая экосистема, много интеграций, привычные настройки | XGBoost |
| Нет времени на тюнинг, нужно хорошо сразу | CatBoost |
| Важна скорость инференса | CatBoost (симметричные деревья) |
Ключевые гиперпараметры (общие): learning_rate, n_estimators + early_stopping_rounds, глубина (max_depth / num_leaves), subsample, colsample_bytree, min_child_weight / min_data_in_leaf, reg_lambda/reg_alpha. Порядок тюнинга: сначала фиксируем небольшой learning_rate и подбираем число деревьев ранней остановкой, потом глубину, потом регуляризацию и сэмплирование.
Вопрос: Почему CatBoost хорош на категориальных признаках? — Он не делает one-hot (взрыв размерности при высокой кардинальности) и не делает наивный target encoding (утечка). Вместо этого использует упорядоченные целевые статистики: для каждого объекта категория кодируется по «истории» — только по объектам, идущим раньше в случайной перестановке. Плюс усреднение по нескольким перестановкам снижает дисперсию оценки.
27. Стекинг и блендинг
Важность на собеседовании: 4/10
████░░░░░░🔥 Иногда. Спрашивают как третий пункт после бэггинга и бустинга — «а что ещё бывает». Обычно достаточно объяснить схему и упомянуть про out-of-fold предсказания. В проде используют редко из-за сложности поддержки.
Стекинг. Обучаем несколько разнородных базовых моделей, их предсказания становятся признаками для мета-модели.
Критичный момент — out-of-fold. Мета-модель должна учиться на предсказаниях, которые базовые модели сделали на не виденных ими данных. Иначе базовые модели «подглядят» и мета-модель научится доверять переобученным предсказаниям. Схема: k-fold, для каждого фолда базовая модель обучается на остальных и предсказывает свой фолд; из этих OOF-предсказаний собирается обучающая матрица мета-модели.
Мета-модель обычно простая — логистическая/линейная регрессия. Сложная мета-модель на 3–5 признаках переобучится.
Блендинг — упрощение: один hold-out вместо k-fold. Проще и быстрее, но использует меньше данных и даёт более шумную оценку.
Что даёт. Работает, когда базовые модели разнородны и ошибаются по-разному (бустинг + нейросеть + линейная модель). Стекинг пяти вариантов одного и того же бустинга почти ничего не даёт.
Почему редко в проде. Прирост обычно 0.5–2%, а стоимость — кратный рост латентности инференса и сложности поддержки (нужно версионировать и мониторить N моделей). Это популярно на Kaggle и почти не встречается в реальных системах. Так и стоит ответить — интервьюер оценит трезвость.
Вопрос: Чем стекинг отличается от бэггинга? — Бэггинг: одинаковые модели на разных подвыборках, объединение простым усреднением, цель — снизить variance. Стекинг: разные модели на одних и тех же данных, объединение обучаемой мета-моделью, цель — использовать разную природу ошибок.
Часть 6 из 17 конспекта для подготовки к собеседованиям на NLP/LLM-разработчика. Остальные части — в разделе «Собесы».
Оставить отзыв
Комментарии
Загрузка комментариев...
★ Оставить отзыв