Темы 11–16: bias–variance, метрики классификации и регрессии, ROC-AUC против PR-AUC, метрики ранжирования и кросс-валидация без утечек.
Это самая опрашиваемая часть на РФ-собесах. Именно здесь режут кандидатов, которые «умеют звать LLM API, но не знают, что такое recall». По данным разборов собеседований 2026 года типовой набор обязательных вопросов: метрики, bias–variance, L1/L2, деревья, «чем случайный лес отличается от градиентного бустинга», градиентный спуск, интерпретация для бизнеса.
11. Постановка задачи и bias–variance
Важность на собеседовании: 10/10
██████████🔥🔥🔥 Критично. Bias–variance спрашивают на большинстве ML-секций, часто первым вопросом. Копают глубоко: разложение ошибки, куда попадает каждая модель, как лечить каждую составляющую. Обязательно уметь объяснить на пальцах и связать с бэггингом/бустингом.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Разложение ошибки на 3 части | 10/10 |
| Диагностика по train/valid | 10/10 |
| Связь с бэггингом и бустингом | 10/10 |
| 5 способов бороться с переобучением | 10/10 |
| Двойной спуск | 4/10 |
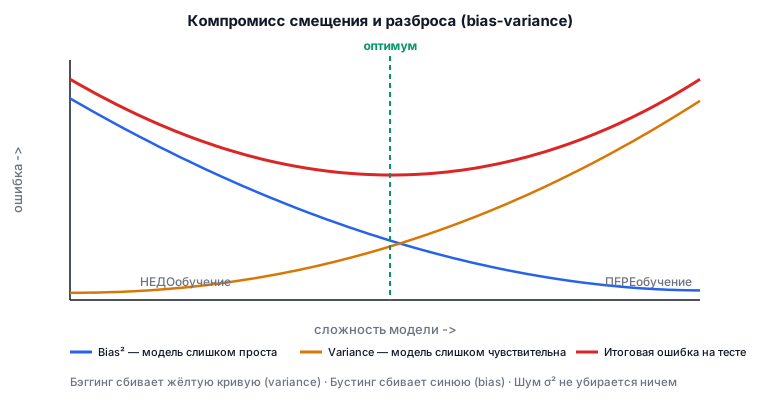
Разложение ошибки. Для квадратичной потери ожидаемая ошибка на новом объекте раскладывается на три части:
E[(y − f̂(x))²] = Bias²[f̂(x)] + Var[f̂(x)] + σ²
                   ↑систематическая  ↑разброс      ↑неустранимый шум
На пальцах.
- Bias (смещение) — насколько модель систематически промахивается из-за того, что она слишком проста. Стрельба всегда левее мишени. Пример: линейная модель на явно нелинейных данных.
- Variance (разброс) — насколько сильно модель меняется при смене обучающей выборки. Пули разлетаются по всей мишени. Пример: глубокое дерево без ограничений.
- σ² (шум) — неустранимая часть: разметка неидеальна, признаков не хватает. Никакая модель это не победит.
Trade-off. Усложняя модель, снижаем bias и повышаем variance. Оптимум — посередине; там минимум ошибки на валидации.
| Симптом | Диагноз | Лечение |
|---|---|---|
| Train-ошибка большая, valid ≈ train | Недообучение (высокий bias) | Сложнее модель, больше признаков, меньше регуляризации, дольше учить |
| Train-ошибка маленькая, valid сильно хуже | Переобучение (высокий variance) | Больше данных, регуляризация, упрощение, ранняя остановка, dropout, ансамбли |
| Обе большие и близки | Модель не подходит либо признаки нерелевантны | Другая постановка/признаки |
| Valid лучше train | Почти всегда баг: утечка, неверный сплит, dropout только на train | Проверить пайплайн |
Связь с ансамблями (это ключ ко всей части II):
- Бэггинг усредняет много моделей с высоким variance и низким bias → снижает variance, bias почти не меняет. Отсюда Random Forest из глубоких деревьев.
- Бустинг последовательно наращивает сложность из слабых моделей → снижает bias, но повышает variance при слишком долгом обучении. Отсюда неглубокие деревья (depth 3–8) и ранняя остановка.
Двойной спуск (для senior). У очень больших моделей (нейросети, LLM) классическая U-образная кривая нарушается: после точки интерполяции ошибка на тесте снова падает. Поэтому «переобучение по числу параметров» — устаревшая интуиция для глубокого обучения, но полностью рабочая для табличных моделей.
Вопрос: Куда на шкале bias–variance попадают: 1-NN, линрег, RF, бустинг? — 1-NN: нулевой bias на train, огромный variance. Линрег: высокий bias, низкий variance. RF: низкий bias (глубокие деревья) и сниженный усреднением variance. Бустинг: начинает с высокого bias (пни) и постепенно его снижает, variance растёт с числом итераций.
12. Метрики классификации
Важность на собеседовании: 10/10
██████████🔥🔥🔥 Критично, тема №1 по частоте. Спрашивают на 100% ML-секций и копают максимально глубоко: определения, вывод из матрицы ошибок, выбор метрики под бизнес, что будет при дисбалансе, как двигать порог. Именно здесь чаще всего проваливаются кандидаты, которые «делали модели, но не думали про метрики». Разжёвано максимально подробно — это стоит вложений.
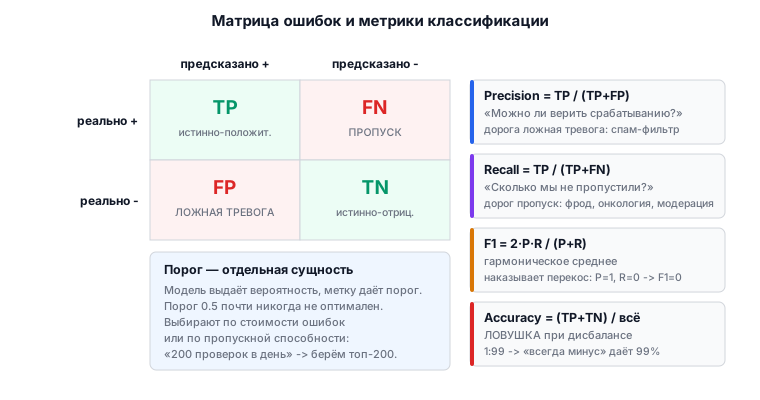
Матрица ошибок
| Предсказано + | Предсказано − | |
|---|---|---|
| Реально + | TP (истинно-положительный) | FN (ошибка II рода, пропуск) |
| Реально − | FP (ошибка I рода, ложная тревога) | TN (истинно-отрицательный) |
Мнемоника: FP — это «ложная тревога» (сказали «пожар», пожара нет). FN — это «пропуск» (пожар есть, промолчали).
Метрики и их смысл
-
Accuracy
= (TP+TN)/всё. Доля правильных ответов. Ловушка: при дисбалансе 1:99 модель «всегда отрицательный» даёт 99% accuracy и нулевую пользу. Если кандидат приносит accuracy на дисбалансе — минус балл. Использовать только при сбалансированных классах и равной цене ошибок. -
Precision (точность)
= TP/(TP+FP). Из тех, кого мы назвали положительными, какая доля действительно положительна. Отвечает на вопрос: «можно ли верить срабатыванию?». Важна там, где ложная тревога дорога: спам-фильтр (письмо от клиента в спаме — потеря денег), автоблокировка объявлений, рекомендация дорогого действия. -
Recall (полнота, TPR, чувствительность)
= TP/(TP+FN). Из всех реально положительных какую долю мы нашли. «Сколько мы не пропустили?». Важна там, где пропуск дорог: детекция фрода, онкология, поиск утечек ПДн, модерация опасного контента. -
Специфичность (TNR)
= TN/(TN+FP). Доля отрицательных, правильно отклонённых.FPR = 1 − TNR. -
F1
= 2·P·R/(P+R)— гармоническое среднее. Гармоническое, а не арифметическое, потому что оно наказывает перекос: при P=1.0, R=0.0 арифметическое даёт 0.5, F1 даёт 0. F-beta= (1+β²)PR/(β²P+R): β=2 — вес recall вдвое выше, β=0.5 — вес precision выше. На собесе хорошо звучит: «мы использовали F2, потому что пропуск стоил примерно вчетверо дороже ложной тревоги». -
Balanced accuracy = среднее recall по классам. Честная замена accuracy при дисбалансе.
-
MCC (коэффициент Мэтьюса) — корреляция между предсказанием и истиной, ∈[−1,1]. Единственная метрика, использующая все четыре ячейки матрицы и устойчивая к дисбалансу. Упоминание MCC — заметный плюс к ответу.
-
Cohen's kappa — согласие с поправкой на случайное совпадение. Чаще для оценки согласованности разметчиков, чем моделей.
Многоклассовое усреднение (частый уточняющий вопрос)
- macro — считаем метрику по каждому классу и усредняем без весов. Редкий класс имеет тот же вес, что и частый → «честно к меньшинствам».
- weighted — усреднение с весами по числу объектов класса. Ближе к accuracy, редкие классы почти не видны.
- micro — суммируем TP/FP/FN по всем классам, затем считаем. При однометочной классификации
micro-F1 = accuracy. Это популярный вопрос-ловушка.
Правило: если важны редкие классы — macro; если важна общая масса — weighted/micro.
Порог — отдельная сущность
Модель выдаёт вероятность, а метка получается сравнением с порогом. Порог 0.5 почти никогда не оптимален, особенно при дисбалансе или несимметричных ценах ошибок.
Как выбирать по-взрослому: задать стоимости C_FP и C_FN, минимизировать ожидаемые издержки C_FP·FP(t) + C_FN·FN(t) по порогу t на валидации. Либо зафиксировать операционное ограничение: «не более 200 срабатываний в день на ручную проверку» → берём топ-200 по скору, отсюда и порог.
from sklearn.metrics import precision_recall_curve
import numpy as np
p, r, thr = precision_recall_curve(y_val, proba_val)
# порог при требовании precision >= 0.9
idx = np.argmax(p[:-1] >= 0.9)
print("threshold:", thr[idx], "recall at it:", r[idx])
Красный флаг для интервьюера: «модель выдала 0.7, значит класс положительный» — без обсуждения, откуда взялся порог.
Вопросы:
- Задача — антифрод, фрода 0.3%. Какие метрики берёте? — Accuracy бесполезна. Основная — PR-AUC (или recall при фиксированном precision / при фиксированном числе алертов), потому что бизнес-ограничение обычно «сколько кейсов команда может проверить в день». Дополнительно — стоимость: сумма пропущенного фрода в рублях против стоимости проверки.
- Recall вырос с 0.6 до 0.9, precision упал с 0.8 до 0.3. Это улучшение? — Зависит от цены ошибок и пропускной способности. Precision 0.3 значит, что 7 из 10 алертов ложные — если проверяют люди, нагрузка выросла втрое. Правильный ответ — считать в деньгах, а не сравнивать метрики абстрактно.
13. ROC-AUC против PR-AUC
Важность на собеседовании: 10/10
██████████🔥🔥🔥 Критично. Идёт сразу за метриками и почти всегда с подвохом «а что при дисбалансе». Интервьюеры специально ждут, свалитесь ли вы в дефолтный «беру ROC-AUC». Копают глубоко, включая вероятностную интерпретацию AUC.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Вероятностная интерпретация ROC-AUC | 10/10 |
| Почему при дисбалансе смотрят PR | 10/10 |
| Базовый уровень PR-AUC = доля класса | 8/10 |
| AUC не говорит о калибровке | 8/10 |
| Выбор рабочей точки на кривой | 8/10 |
ROC-кривая: по осям FPR (x) и TPR/recall (y) при переборе порога. ROC-AUC — площадь под ней.
Вероятностная интерпретация (её просят назвать): ROC-AUC — вероятность того, что случайно взятый положительный объект получит более высокий скор, чем случайно взятый отрицательный. 0.5 — случайное угадывание, 1.0 — идеальное ранжирование. Отсюда следствие: AUC зависит только от порядка объектов, а не от абсолютных значений вероятностей. Любое монотонное преобразование скоров не меняет AUC — поэтому высокий AUC ничего не говорит о калибровке.
PR-кривая: по осям recall (x) и precision (y). PR-AUC (≈ average precision).
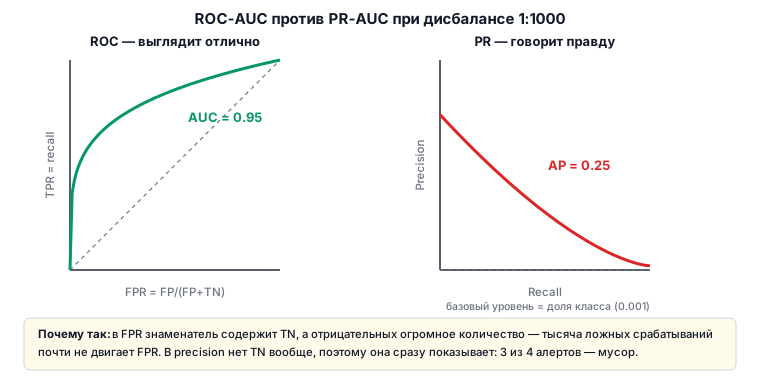
Ключевое различие. В формуле FPR = FP/(FP+TN) знаменатель содержит TN. При сильном дисбалансе отрицательных огромное количество, и даже большое абсолютное число FP даёт крошечный FPR. ROC-кривая этого «не замечает». Precision же = TP/(TP+FP) вообще не содержит TN и реагирует на ложные срабатывания напрямую.
Практическое следствие: на дисбалансе 1:1000 модель может иметь ROC-AUC 0.95 и PR-AUC 0.25 одновременно. ROC говорит «ранжирую отлично», PR говорит «на практике 3 из 4 алертов — мусор». Обе верны, но решение принимают по второй.
Ещё одно свойство: базовый уровень PR-AUC равен доле положительного класса (при 1% положительных случайная модель даёт PR-AUC ≈ 0.01), тогда как базовый ROC-AUC всегда 0.5 независимо от баланса. Поэтому PR-AUC несравним между датасетами с разной долей класса — это тонкий момент, который отличает сильного кандидата.
Когда что:
| Ситуация | Метрика |
|---|---|
| Классы сбалансированы, важны обе ошибки | ROC-AUC |
| Сильный дисбаланс, интересует положительный класс | PR-AUC |
| Есть жёсткое ограничение по числу проверок | Precision@k / Recall@k |
| Нужны сами вероятности (риск, ставка, цена) | Brier score + калибровочная кривая |
Нюанс для честности (уровень senior). Строго говоря, ROC-AUC не «ломается» на дисбалансе — как метрика ранжирования она остаётся корректной. Проблема в другом: она отвечает на вопрос, который бизнесу не интересен. Формулировка «ROC-AUC не про дисбаланс, а про то, что при дисбалансе вопрос ранжирования перестаёт быть главным» — сильный ответ.
Вопрос: Модель A: ROC-AUC 0.92, PR-AUC 0.31. Модель B: ROC-AUC 0.89, PR-AUC 0.44. Какую в прод? — B, если задача с дисбалансом и мы работаем в зоне высокого precision. Но правильный ход — не выбирать по агрегату, а построить обе PR-кривые и сравнить именно в рабочей точке (при том recall, который требуется бизнесу): кривые могут пересекаться.
14. Метрики регрессии
Важность на собеседовании: 6/10
██████░░░░🔥🔥 Часто. Спрашивают короче и проще, чем классификацию: «чем MAE отличается от MSE», «когда RMSE плох», «что не так с R²». Глубоко не копают.
- MSE
= (1/n)Σ(y−ŷ)²— квадрат штрафует выбросы квадратично. Дифференцируема везде, оптимум — условное среднее. - RMSE
= √MSE— в единицах целевой переменной, поэтому интерпретируема. - MAE
= (1/n)Σ|y−ŷ|— устойчива к выбросам, оптимум — условная медиана. Это важное отличие: если в данных есть редкие огромные значения, MSE будет тянуть предсказание вверх, MAE — нет. - MAPE
= (100/n)Σ|y−ŷ|/|y|— в процентах, удобна бизнесу. Ломается при y близких к нулю и несимметрична (штрафует завышение слабее занижения). Альтернативы: SMAPE, WAPE (Σ|y−ŷ|/Σ|y|— устойчивее, часто используется в прогнозе спроса). - R²
= 1 − SS_res/SS_tot— доля объяснённой дисперсии. Может быть отрицательным, если модель хуже константы-среднего. Растёт при добавлении любого признака → для сравнения моделей с разным числом признаков нужен скорректированный R². - Huber loss — квадратичная вблизи нуля, линейная вдали. Компромисс MSE/MAE, параметр δ задаёт границу.
- Квантильная (pinball) потеря — для прогноза интервалов: обучаем модель предсказывать 10-й и 90-й перцентили, получаем интервал неопределённости. Это сильный ответ на вопрос «как оценить неопределённость прогноза».
Вопрос: Прогноз спроса, в данных есть редкие всплески. MAE или RMSE? — Зависит от цены: если недозаказ на пиках критичен (упущенная выручка), нужен RMSE или квантильная потеря с высоким квантилем — они заставят модель ловить пики. Если пики — это шум/аномалии, то MAE, чтобы они не тянули весь прогноз.
15. Метрики ранжирования
Важность на собеседовании: 7/10
███████░░░🔥 Иногда для общей ML-роли, но 🔥🔥 часто для NLP/LLM — потому что качество retrieval в RAG измеряется именно ими. Знать Recall@k, MRR, NDCG обязательно; вывод формулы NDCG не спросят.
- Precision@k / Recall@k — доля релевантных среди топ-k / доля найденных релевантных. В RAG Recall@k ретривера — главная метрика: если нужного чанка нет в топ-k, генератор его не придумает.
- MRR (Mean Reciprocal Rank)
= (1/|Q|)Σ 1/rank_первого_релевантного. Подходит, когда нужен один правильный ответ (навигационный поиск, QA). - MAP — усреднённая по запросам average precision. Учитывает все релевантные документы.
- NDCG@k
= DCG@k / IDCG@k, гдеDCG = Σ rel_i/log₂(i+1). Единственная из перечисленных, которая работает с градуированной релевантностью (не «релевантно/нет», а оценки 0–3) и учитывает позицию. Стандарт в поиске и рекомендациях. - Hit Rate@k — доля запросов, где хотя бы один релевантный попал в топ-k.
Практика для RAG. Разделяйте метрики ретривера и генератора. Типовой набор: Recall@10 и NDCG@10 для поиска, faithfulness и answer relevancy для ответа. Если падает качество — сначала смотрят Recall@k: примерно в 40% случаев наивный RAG ломается именно на этапе retrieval, а не генерации.
Вопрос: Recall@5 = 0.95, но пользователи жалуются на плохие ответы. Где искать проблему? — Ретривер работает, значит дело в генерации или в порядке: нужный чанк может быть на 5-й позиции и теряться среди мусора (тогда нужен реранкер), либо чанк слишком велик и релевантный факт «размазан» (проблема чанкинга), либо промпт не заставляет модель опираться на контекст.
16. Валидация, кросс-валидация и утечки
Важность на собеседовании: 10/10
██████████🔥🔥🔥 Критично. Утечки данных — одна из шести главных причин отказа на DS-собесах 2026 года. Спрашивают всегда и с практическим уклоном: «как бы вы валидировали вот эту задачу». Копают глубоко, любят подлавливать на временных данных и на группировке.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| 6 источников утечки данных | 10/10 |
| Валидация по времени + зазор (gap) | 10/10 |
| Pipeline: препроцессинг внутри фолда | 10/10 |
| Stratified и GroupKFold — когда что | 9/10 |
| «Валидация 0.95, прод 0.62» — диагностика | 9/10 |
| Nested CV | 6/10 |
Схемы валидации:
- Hold-out — простой сплит. Быстро, но оценка шумная на малых данных.
- k-fold — k разбиений, усреднение. Стандарт, обычно k=5.
- Stratified k-fold — сохраняет долю классов в каждом фолде. Обязателен при дисбалансе.
- GroupKFold — объекты одной группы (один пользователь, один документ, одна фотосессия) целиком в одном фолде. Без этого модель «узнаёт» пользователя, а не закономерность.
- TimeSeriesSplit / walk-forward — обучаемся на прошлом, валидируемся на будущем. Разбиение вперёд по времени, никогда не перемешивая.
- Nested CV — внешний цикл для оценки, внутренний для подбора гиперпараметров. Единственный корректный способ не переобучиться на валидации при активном тюнинге.
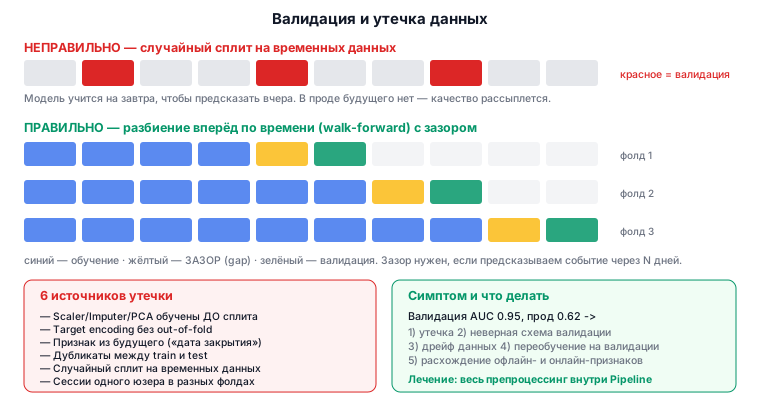
Утечка данных (data leakage) — главная тема. Это ситуация, когда в обучение попадает информация, недоступная в момент реального применения. Симптом: подозрительно высокое качество на валидации, которое рассыпается в проде.
Типовые источники утечки (перечислите их — интервьюер это оценит):
- Препроцессинг до сплита.
StandardScaler,SimpleImputer, отбор признаков, PCA, обученные на всём датасете. ЛечитсяPipeline, где всё внутри фолда. - Target encoding без out-of-fold. Кодируем категорию средним таргетом, включая текущую строку → признак «знает» ответ.
- Признаки из будущего. «Дата закрытия сделки» в задаче предсказания закрытия. Часто выглядит невинно: агрегаты, посчитанные по всему периоду.
- Дубликаты между train и test. Особенно в текстах и картинках — почти одинаковые записи попадают в оба сплита.
- Случайный сплит на временных данных. Модель учится на завтра, предсказывает вчера.
- Группы, размазанные по фолдам. Разные сессии одного пользователя.
Правильный шаблон:
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import cross_val_score, StratifiedKFold

pipe = Pipeline([("scaler", StandardScaler()), ("clf", LogisticRegression())])
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(pipe, X, y, cv=cv, scoring="roc_auc")
# scaler обучается заново внутри каждого фолда — утечки нет
Валидация во времени, с зазором (gap). Если модель предсказывает событие через 7 дней, между train и valid нужен буфер в 7 дней, иначе информация просачивается. Упоминание gap-периода — маркер зрелости.
Вопрос: Валидация даёт AUC 0.95, прод — 0.62. Что проверять? — В порядке убывания вероятности: (1) утечка (препроцессинг до сплита, признак из будущего, дубликаты); (2) неправильная схема валидации (случайный сплит на временных данных, отсутствие группировки); (3) дрейф данных между периодом обучения и продом; (4) переобучение на валидации из-за многократного тюнинга; (5) расхождение офлайн- и онлайн-признаков (train/serving skew).
Часть 4 из 17 конспекта для подготовки к собеседованиям на NLP/LLM-разработчика. Остальные части — в разделе «Собесы».
Оставить отзыв
Комментарии
Загрузка комментариев...
★ Оставить отзыв