В данном блоге доступно 37 постов на разные темы
По запросу нашлось 3 поста
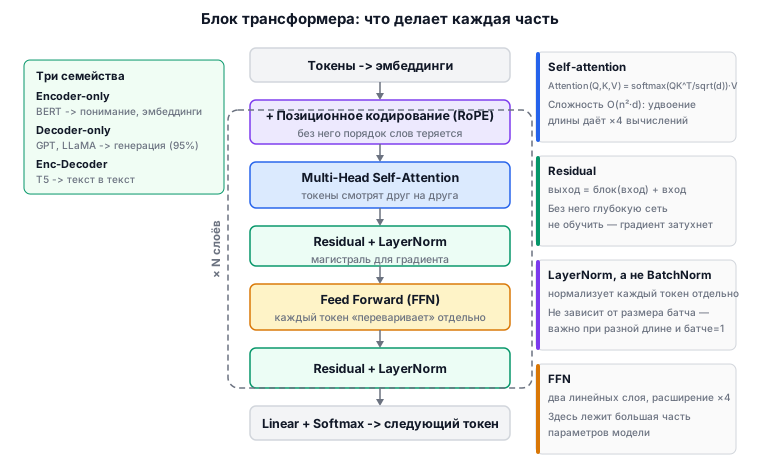
Трансформеры: архитектура, внимание и позиционные кодировки
Темы 40–45: блок трансформера, self-attention через Q, K и V, RoPE и ALiBi, MHA/MQA/GQA и FlashAttention, нормализация, активации и MoE, разница между BERT, GPT и T5. Это ядро собеседования на …
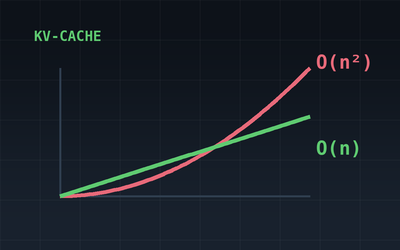
Как KV-кеш поборол O(n²)
Key-Value кеш — отличный пример того, как недостаточно предложить и теоретически обосновать даже такую сильную архитектурную идею, как трансформеры в LLM. Замечание 1. Трансформеры — это архитектурное решение, которое было …
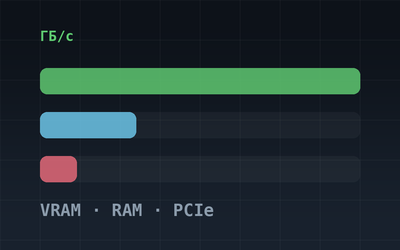
Битва за память: как VRAM, RAM и PCIe влияют на скорость LLM
Как понять, запустится ли модель на локальном ПК Если на ПК только CPU Формула для очень грубой оценки: text ток/с ≈ пропускная способность RAM / размер модели в памяти Во …