Темы 40–45: блок трансформера, self-attention через Q, K и V, RoPE и ALiBi, MHA/MQA/GQA и FlashAttention, нормализация, активации и MoE, разница между BERT, GPT и T5.
Это ядро собеседования на NLP/LLM-разработчика. По разборам реальных интервью здесь спрашивают дольше и глубже всего. Типичная жалоба интервьюеров: кандидат уверенно рисует схему трансформера, но плывёт на вопросах про токенизацию, позиционные кодировки и инференс. Поэтому дальше подробно разобраны именно те места, где обычно тонут.
40. Архитектура трансформера
Важность на собеседовании: 10/10
██████████🔥🔥🔥 Критично. Спрашивают на каждом NLP-собесе. Просят нарисовать схему и объяснить назначение каждого блока. Копают до деталей: зачем residual, почему LayerNorm а не BatchNorm, что делает FFN.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Схема блока и назначение каждой части | 10/10 |
| Зачем residual-связи | 9/10 |
| LayerNorm, а не BatchNorm — почему | 9/10 |
| Что делает FFN | 8/10 |
| Три семейства: encoder/decoder/enc-dec | 9/10 |
| Почему decoder-only победил | 8/10 |
Главная идея простыми словами. До 2017 года текст обрабатывали по одному слову за раз (RNN). Это медленно и модель забывает начало длинного текста. Трансформер обрабатывает все слова одновременно, а связи между ними находит механизмом внимания. Отсюда и скорость (можно загрузить всю видеокарту), и хорошая работа с длинными зависимостями.
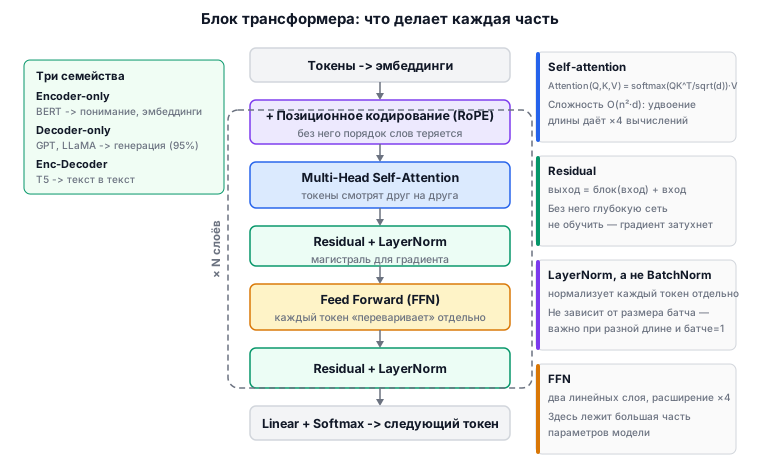
Из чего собран энкодер (один блок, повторяется N раз):
- Multi-head self-attention — токены «смотрят» друг на друга и собирают информацию из контекста.
- Residual + LayerNorm — прибавляем вход блока к выходу и нормализуем.
- Feed Forward (FFN/MLP) — «переваривание» собранной информации, отдельно для каждого токена.
- Residual + LayerNorm ещё раз.
Декодер отличается двумя вещами: внимание в нём маскированное (нельзя подглядывать в будущие токены) и есть дополнительный слой cross-attention, где запросы берутся из декодера, а ключи и значения — из энкодера.
Зачем каждый кусок (это и спрашивают):
- Positional encoding. Без него модель не отличит «кот сел на коврик» от «коврик сел на кота» — для внимания это просто мешок векторов, порядок в нём не закодирован. RNN такой проблемы не имел, потому что читал по порядку.
- Residual connection (
выход = блок(вход) + вход). Даёт градиенту «магистраль» напрямую к ранним слоям. Без этого 30-слойную модель не обучить — градиент затухнет. - LayerNorm, а не BatchNorm. BatchNorm считает статистики по всему батчу, а у нас последовательности разной длины и на инференсе батч может быть равен единице. LayerNorm нормализует каждый вектор токена отдельно — от размера батча не зависит вообще. Это стандартный вопрос.
- FFN. Два линейных слоя с нелинейностью посередине: сначала расширяем размерность примерно в 4 раза, потом сжимаем обратно. Работает независимо по каждому токену. Если attention — это «обмен информацией между словами», то FFN — «обдумывание полученного каждым словом в одиночку». Здесь же лежит большая часть параметров модели.
Три семейства архитектур:
| Тип | Кто | Для чего |
|---|---|---|
| Encoder-only | BERT и родня | Понимание текста: классификация, NER, эмбеддинги, поиск |
| Decoder-only | GPT, LLaMA, Qwen, Mistral | Генерация. Сегодня это 95% всех LLM |
| Encoder-decoder | T5, оригинальный трансформер | Перевод, задачи «текст → текст» |
Вопрос: Почти все современные генеративные LLM — decoder-only. Почему не encoder-decoder? — Decoder-only проще (одна стопка блоков вместо двух), лучше масштабируется, и обучается на одной задаче — предсказании следующего токена — на любом сыром тексте из интернета. При достаточном размере он и так умеет всё, что умел encoder-decoder, включая перевод и суммаризацию, просто через промпт.
41. Механизм внимания детально
Важность на собеседовании: 10/10
██████████🔥🔥🔥 Критично, самая опрашиваемая тема части. Просят написать формулу, объяснить смысл Q, K, V, сказать сложность и обосновать деление на корень. Копают максимально глубоко.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Формула внимания и смысл Q, K, V | 10/10 |
| Зачем делить на √d_k | 9/10 |
| Multi-head: зачем несколько голов | 9/10 |
| Маскированное внимание | 8/10 |
| Сложность O(n²·d) и её последствия | 9/10 |
| Cross-attention | 6/10 |
Формула:
Attention(Q, K, V) = softmax( Q·Kᵀ / √d_k ) · V
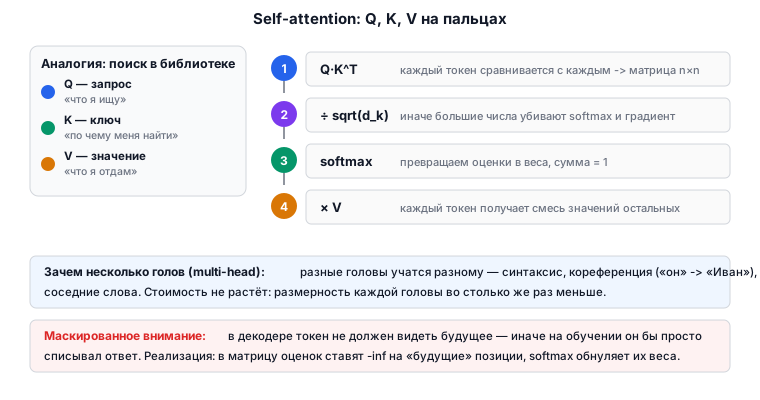
Что это значит по-человечески. Каждый токен превращается в три вектора умножением на обучаемые матрицы:
- Q (query, запрос) — «что я ищу».
- K (key, ключ) — «что я собой представляю, по чему меня можно найти».
- V (value, значение) — «что я отдам тому, кто меня нашёл».
Аналогия — поиск в библиотеке: запрос это ваш поисковый вопрос, ключи это названия книг на полке, значения это содержимое книг.
Дальше по шагам:
Q·Kᵀ— каждый токен сравнивается с каждым, получаем матрицуn×n«насколько токен i интересен токену j».- Делим на
√d_k. softmaxпо строкам — превращаем оценки в веса, которые в сумме дают 1.- Умножаем на
V— каждый токен получает взвешенную смесь значений всех остальных.
Зачем делить на √d_k (спрашивают почти всегда). Скалярное произведение двух случайных векторов размерности d имеет разброс порядка d. Чем больше размерность, тем больше разброс чисел, попадающих в softmax. Большие числа в softmax дают почти вырожденное распределение — «всё внимание в одну точку», а градиенты при этом близки к нулю и обучение останавливается. Деление на √d_k возвращает разброс к единице.
Multi-head attention. Вместо одного большого внимания делаем несколько маленьких («голов») параллельно и склеиваем результаты. Зачем: разные головы учатся разному — одна следит за синтаксисом, другая за кореференцией («он» → «Иван»), третья за соседними словами. Общая стоимость при этом не растёт, потому что размерность каждой головы во столько же раз меньше.
Маскированное внимание. В декодере токен не должен видеть будущее — иначе на обучении он просто списывал бы ответ. Реализуется просто: в матрицу оценок перед softmax добавляют −∞ во все позиции «будущего», и после softmax их веса становятся нулевыми.
Сложность — O(n²·d), где n — длина последовательности. Это ключевой факт: удвоение длины контекста учетверяет вычисления на внимании. Отсюда весь набор ухищрений с длинным контекстом.
Виды внимания:
- Self-attention — токены смотрят на токены той же последовательности.
- Cross-attention — декодер смотрит на выход энкодера (Q из декодера, K и V из энкодера).
Вопрос: Почему нельзя обойтись без отдельных матриц Q, K, V — брать просто сходство эмбеддингов? — Тогда матрица внимания была бы симметричной («я тебе интересен ровно настолько, насколько ты мне»), а в языке отношения несимметричны: прилагательное должно смотреть на существительное сильнее, чем наоборот. Отдельные обучаемые проекции разрывают эту симметрию и позволяют модели выучить, какие именно отношения ей нужны.
42. Позиционные кодировки: RoPE и ALiBi
Важность на собеседовании: 9/10
█████████░🔥🔥🔥 Критично для NLP-роли. RoPE спрашивают почти всегда — это стандарт всех современных LLM. Ждут понимания «относительные vs абсолютные» и связи с длиной контекста.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Зачем нужны позиционные кодировки вообще | 9/10 |
| RoPE: относительные позиции даром | 9/10 |
| Расширение контекста после обучения | 7/10 |
| ALiBi | 5/10 |
| Обучаемые и синусоидальные | 5/10 |
Проблема. Внимание не различает порядок: переставьте слова местами — результат не изменится. Значит информацию о позиции надо подать явно.
Как это делали и делают:
- Синусоидальные (оригинальный трансформер). К эмбеддингу прибавляют вектор из синусов и косинусов разных частот. Не обучаются, теоретически обобщаются на любую длину.
- Обучаемые (BERT, GPT-2). Просто таблица «позиция → вектор», обучается вместе с моделью. Минус жёсткий: за пределы максимальной длины из обучения выйти нельзя вообще — для позиции 5000 вектора не существует.
- Относительные (Transformer-XL, DeBERTa). Кодируют не «какая это позиция», а «на каком расстоянии друг от друга токены». Лучше обобщаются.
- RoPE (Rotary Position Embedding) — сегодняшний стандарт (LLaMA, Qwen, Mistral, почти всё). Вместо прибавления вектора позиции поворачивает векторы Q и K на угол, пропорциональный позиции. Ключевое свойство: при вычислении
Q·Kᵀуглы вычитаются, и результат зависит только от разницы позиций. То есть абсолютные позиции на входе, относительные на выходе — бесплатно и элегантно. - ALiBi. Ещё проще: к оценкам внимания добавляется линейный штраф, растущий с расстоянием между токенами — «чем дальше, тем меньше внимания». Хорошо экстраполируется на длины больше обучающих.
Почему RoPE победил (готовый ответ). Даёт относительные позиции без дополнительных параметров, работает с любой длиной входа, хорошо сочетается с FlashAttention, и — главное практическое свойство — контекст можно расширять после обучения, меняя базовую частоту вращения (методы вроде NTK-aware scaling и YaRN). Именно так модели с обучением на 4k получают контекст 32k и больше.
Вопрос: Модель обучена на контексте 4k, вы подали 16k. Что произойдёт? — Если позиционные кодировки обучаемые — ошибка или мусор на выходе. Если RoPE — модель отработает, но качество на дальних позициях просядет, потому что таких углов поворота она не видела. Лечится расширением контекста (position interpolation / YaRN) с небольшим дообучением.
43. MHA, MQA, GQA и FlashAttention
Важность на собеседовании: 8/10
████████░░🔥🔥 Часто, для senior 🔥🔥🔥. Это уже «инференсные» вопросы, которые отделяют тех, кто читал статьи, от тех, кто выводил модели в прод. GQA и FlashAttention надо знать обязательно.
Проблема, из которой всё выросло. При генерации мы храним KV-кэш (см. тему 51). Его размер пропорционален числу голов внимания. У большой модели с длинным контекстом кэш может весить больше самих весов. Нужно его уменьшить.
- MHA (Multi-Head Attention) — классика: у каждой головы свои K и V. Максимальное качество, максимальный кэш.
- MQA (Multi-Query Attention) — все головы делят одни K и V (разными остаются только Q). Кэш уменьшается в число раз, равное числу голов. Но качество заметно падает.
- GQA (Grouped-Query Attention) — компромисс и сегодняшний стандарт: головы разбиваются на группы, внутри группы общие K и V. Например, 32 головы запросов и 8 групп KV — кэш в 4 раза меньше, качество почти как у MHA. Используется в LLaMA 3, Qwen, Mistral.
FlashAttention — про что он на самом деле. Это не новый тип внимания, математика ровно та же, результат бит в бит тот же. Это способ считать то же самое эффективнее.
Суть: обычная реализация создаёт в памяти видеокарты полную матрицу внимания n×n. При n=8192 это 64 миллиона чисел на одну голову — и упирается всё не в вычисления, а в скорость чтения/записи в медленную память GPU (HBM). FlashAttention режет Q, K, V на блоки, считает внимание поблочно в быстрой встроенной памяти (SRAM) и никогда не материализует полную матрицу. Softmax при этом считается «онлайн», по блокам, с сохранением численной устойчивости.
Результат: в несколько раз быстрее и память по длине растёт линейно, а не квадратично. Полезное следствие — можно обучать на более длинном контексте.
Термины, которые тут же спросят:
- Compute-bound — узкое место в вычислениях, данные подъезжают быстро, ядра не успевают.
- Memory-bound — узкое место в скорости памяти: ядра простаивают, ожидая данные.
- Kernel fusion — объединение нескольких операций в одну, чтобы не гонять промежуточные результаты в медленную память и обратно. FlashAttention — частный случай этой идеи.
Вопрос: Меняет ли FlashAttention качество модели? — Нет. Это точный алгоритм, а не приближение. Меняются только скорость и потребление памяти. Путать его с разреженным вниманием (Longformer, BigBird), которое как раз приближает и качество затрагивает, — типичная ошибка.
44. Нормализация, активации, MoE
Важность на собеседовании: 7/10
███████░░░🔥🔥 Часто. Вопрос «чем современная LLaMA отличается от ванильного трансформера» — популярный способ проверить, следите ли вы за областью. MoE спрашивают всё чаще, потому что почти все крупные модели 2026 года на нём.
Что поменялось в архитектуре с 2017 года — готовый список для ответа:
- Pre-Norm вместо Post-Norm. Раньше нормализация стояла после блока и residual-связи, теперь — перед блоком. Причина: с Pre-Norm градиент идёт к ранним слоям по «чистой» residual-магистрали, ничем не искажаясь. Это позволяет обучать очень глубокие модели без расхождения.
- RMSNorm вместо LayerNorm. LayerNorm вычитает среднее и делит на стандартное отклонение. RMSNorm только делит на корень из среднего квадратов — среднее не вычитает. Меньше операций, качество то же. Мелочь, но она применяется в каждом блоке к каждому токену, поэтому экономия заметна.
- SwiGLU вместо ReLU/GELU в FFN. Идея «ворот»: один линейный слой считает признаки, второй — коэффициенты «насколько пропустить», результаты перемножаются поэлементно. FFN становится выразительнее. Цена — три линейные матрицы вместо двух (поэтому скрытую размерность обычно берут не 4×, а ~2.7×, чтобы число параметров осталось прежним).
- RoPE вместо абсолютных позиций (тема 42).
- GQA вместо MHA (тема 43).
- MoE вместо плотного FFN — у части моделей.
Mixture of Experts (MoE) простыми словами. Вместо одного FFN-блока ставят несколько (например, 8 или 128) — это «эксперты». Маленькая сеть-роутер для каждого токена решает, к каким 1–2 экспертам его отправить. Токен проходит только через выбранных, остальные не считаются.
- Total parameters — сколько параметров в модели всего.
- Active parameters — сколько реально участвует в обработке одного токена.
Модель может иметь 400 млрд параметров всего и активировать 30 млрд на токен. Знаний как у огромной модели, а вычислений как у средней. Это главный ответ на вопрос «зачем MoE».
Обратная сторона (её спрашивают): всех экспертов всё равно надо держать в памяти, так что по VRAM экономии нет — экономия только по вычислениям. Плюс проблема балансировки: роутер склонен полюбить нескольких экспертов, остальные становятся «мёртвыми». Лечится вспомогательным лоссом на равномерность загрузки, а в новых работах — балансировкой без дополнительного лосса (через смещения в роутере).
Вопрос: У вас MoE-модель на 8 экспертов, top-2. Во сколько раз меньше вычислений, чем у плотной модели того же размера? — Примерно в 4 раза по FFN-части (2 эксперта из 8), но не в 4 раза по всей модели: внимание, эмбеддинги и роутер считаются целиком. И память под веса нужна вся.
45. BERT vs GPT vs T5
Важность на собеседовании: 9/10
█████████░🔥🔥🔥 Критично. Классический вопрос «в чём разница энкодера и декодера» задают почти на каждом NLP-собесе. Копают средне: важно понимать, какая задача предобучения и что из этого следует.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Разница энкодера и декодера | 10/10 |
| MLM как задача предобучения | 9/10 |
| Почему BERT не генерирует | 8/10 |
| Как получить эмбеддинг предложения | 8/10 |
| Зачем BERT в 2026 (скорость и цена) | 8/10 |
| RoBERTa, ELECTRA, DeBERTa, DistilBERT | 5/10 |
BERT (encoder-only, 2018).
- Видит весь текст сразу, в обе стороны. Отсюда «Bidirectional».
- Предобучение — MLM (Masked Language Model): 15% токенов маскируются, модель их восстанавливает. Плюс (в оригинале) NSP — определить, идут ли два предложения подряд.
- Для чего: классификация, NER, поиск, эмбеддинги. Генерировать не умеет.
- Родня: RoBERTa (убрали NSP, динамические маски, больше данных), ALBERT (общие параметры между слоями), ELECTRA (вместо восстановления маски — определить, был ли токен подменён; эффективнее по вычислениям), DeBERTa (раздельное кодирование содержания и позиции), DistilBERT (дистилляция: 40% меньше, ~95% качества).
GPT (decoder-only, 2018+).
- Видит только левый контекст, генерирует токен за токеном.
- Предобучение — предсказание следующего токена на сыром тексте.
- Для чего: генерация, диалог, а через промпт — практически любая задача.
T5 (encoder-decoder, 2019).
- Всё сводится к формату «текст на входе → текст на выходе», включая классификацию.
- Предобучение — span corruption: выкидываются куски текста, модель их восстанавливает.
Главное следствие, которое надо проговорить. BERT нельзя использовать для генерации, потому что он обучен видеть текст целиком, а при генерации будущего ещё нет. GPT можно использовать для понимания, но эмбеддинги у него хуже, чем у специализированных энкодеров — потому что каждый токен видит только левую часть, и вектор не «знает» о том, что справа.
Как получить вектор всего текста из BERT (частый практический вопрос):
- Взять вектор токена
[CLS]. - Усреднить векторы всех токенов (mean pooling) — на практике обычно работает лучше
[CLS]. - Правильный ответ: использовать модель, специально обученную давать эмбеддинги предложений (Sentence-BERT, E5, BGE). Обычный BERT «из коробки» даёт плохие эмбеддинги для сравнения по косинусу, потому что его этому не учили.
Вопрос: Зачем в 2026 году нужен BERT, если есть LLM? — Скорость и стоимость. Классификация 10 миллионов сообщений энкодером на 100M параметров — минуты и копейки; той же LLM — часы и заметные деньги. Плюс эмбеддинги для поиска почти всегда делают энкодерами. Практическая схема: LLM размечает несколько тысяч примеров, на них обучается маленький энкодер, он и работает в проде.
Часть 9 из 17 конспекта для подготовки к собеседованиям на NLP/LLM-разработчика. Остальные части — в разделе «Собесы».
Оставить отзыв
Комментарии
Загрузка комментариев...
★ Оставить отзыв