Темы 56–58: техники промптинга, полный RAG-пайплайн и места, где он ломается, гибридный поиск, реранкинг и стратегии чанкинга.
Это то, за что вас нанимают. По разборам вакансий и интервью 2026 года работодатели проверяют не теорию, а способность собрать, измерить и вывести в прод систему поверх готовой модели. Главный сигнал, который ищут интервьюеры: есть ли у вас культура измерения. Ответ «смотрели глазами» на вопрос «как поняли, что стало лучше» — прямая причина отказа даже сильным кандидатам.
56. Промпт-инжиниринг
Важность на собеседовании: 8/10
████████░░🔥🔥🔥 Критично. Спрашивают всегда, но не «напиши промпт», а «как ты понимаешь, что промпт стал лучше» и «как ты версионируешь промпты». Именно инженерный подход к промптам, а не знание приёмов, отличает сильного кандидата.
Разбивка по подтемам:
| Подтема | Балл | Комментарий |
|---|---|---|
| Zero-shot / few-shot / in-context learning | 8/10 | Обязательный минимум, спросят точно |
| Chain-of-Thought и когда он не нужен | 8/10 | Частый вопрос, особенно про reasoning-модели |
| Структура хорошего промпта | 7/10 | Просят объяснить на примере |
| Версионирование и A/B промптов | 8/10 | Отличает инженера от «пользователя ChatGPT» |
| Self-consistency, ToT и экзотика | 4/10 | Достаточно знать названия |
База: три режима.
- Zero-shot — только инструкция. «Определи тональность отзыва.»
- Few-shot — инструкция плюс 2–5 примеров «вход → выход». Модель копирует формат, стиль и логику из примеров. Это самый дешёвый способ поднять качество.
- In-context learning — общее название явления: модель адаптируется к задаче без изменения весов, только из содержимого промпта.
Chain-of-Thought (CoT). Просим модель рассуждать по шагам перед ответом. Работает на многошаговых задачах: математика, логика, разбор условий. Важная оговорка 2026 года: у reasoning-моделей (тех, что тратят внутренние токены на размышление) явный CoT в промпте часто не нужен и даже вреден — они и так рассуждают, а инструкция «думай пошагово» ломает их собственный процесс. Проговорить это различие — сильный ход.
Из чего состоит хороший промпт:
- Роль/контекст — «Ты — специалист поддержки банка».
- Задача — что конкретно сделать.
- Данные — сам текст, документы, контекст (лучше в явных разделителях или тегах).
- Ограничения — чего не делать, что делать при нехватке информации.
- Формат вывода — желательно схемой, а не описанием словами.
- Примеры — если формат нетривиальный.
Практические правила, которые стоит назвать:
- Стабильное — в начало, изменяемое — в конец. Так работает кэширование промпта: неизменный префикс считается один раз, и вы платите за него в разы меньше и получаете быстрее первый токен.
- Позитивные инструкции работают лучше отрицаний. «Отвечай только по документам» лучше, чем «не выдумывай».
- Обязательно предусмотрите путь отказа: «Если в контексте нет ответа — напиши "не найдено"». Без этого модель будет заполнять пробел выдумкой.
- Разделяйте инструкции и данные. Пользовательский текст и результаты инструментов — это недоверенные данные, а не инструкции. Это и защита от инъекций (тема 68).
Что реально спрашивают — инженерная часть:
- Версионирование. Промпты — это код. Хранить в репозитории, версионировать, менять только через ревью и прогон на eval-наборе.
- Как измерять улучшение. Не «стало лучше на моём примере», а прогон на фиксированном наборе из 50–200 кейсов с метриками, желательно с A/B на трафике.
- Регрессии. Изменение промпта под один кейс регулярно ломает три других. Отсюда обязательный набор регрессионных тестов.
Вопрос: Как понять, что новый промпт лучше старого? — Собрать golden-набор из реальных запросов с эталонными ответами (или критериями), прогнать оба промпта, посчитать метрики (задачные + LLM-судья), проверить, что не просели ранее работавшие кейсы, и, если фича живая, поставить A/B на части трафика с продуктовой метрикой. Отдельно смотреть стоимость и латентность — промпт, который лучше на 2% и дороже вдвое, обычно не нужен.
57. RAG: базовая архитектура
Важность на собеседовании: 10/10
██████████🔥🔥🔥 Критично, главная тема части. Это самый частый вопрос system-design секции для LLM-ролей. Копают максимально глубоко: каждый этап, где ломается, как чинить, как измерять. Разобрано досконально.
Разбивка по подтемам:
| Подтема | Балл | Комментарий |
|---|---|---|
| Полный пайплайн от документа до ответа | 10/10 | Попросят нарисовать/рассказать целиком |
| Где RAG ломается и как диагностировать | 10/10 | Главный вопрос senior-уровня |
| RAG vs файнтюн vs длинный контекст | 10/10 | Проверка инженерного суждения |
| Гибридный поиск (BM25 + вектора) | 9/10 | Ждут понимания, зачем лексика |
| Реранкинг | 9/10 | Самая окупаемая оптимизация |
| Метаданные и права доступа | 7/10 | Всплывает в корпоративных кейсах |
Зачем RAG
У модели три проблемы: она не знает ваших внутренних данных, её знания устарели на момент обучения, и она не может дать ссылку на источник. RAG решает все три: перед ответом мы находим релевантные куски документов и кладём их в промпт.
Формула для запоминания: файнтюн меняет как модель отвечает, RAG даёт что ей знать.
Пайплайн целиком
Офлайн (индексация):
- Загрузка — PDF, DOCX, HTML, база, Confluence. Самая недооценённая часть: парсинг PDF с таблицами — отдельная боль, и упомянуть это полезно.
- Очистка — убрать навигацию, колонтитулы, повторяющиеся шапки, нормализовать формат.
- Чанкинг — разбить на куски (тема 58).
- Обогащение метаданными — источник, дата, раздел, автор, права доступа. Понадобится для фильтрации и цитирования.
- Эмбеддинг — превратить чанки в векторы.
- Индексация — сохранить в векторную БД плюс, как правило, отдельный лексический индекс (BM25).
Онлайн (запрос):
- Обработка запроса — переформулировка, расширение, декомпозиция сложного вопроса.
- Поиск — вектора + BM25, объединение результатов.
- Реранкинг — cross-encoder переупорядочивает топ-50 кандидатов.
- Сборка контекста — отобрать топ-k, уложиться в бюджет токенов, разметить источники.
- Генерация — промпт с инструкцией отвечать только по контексту.
- Постобработка — проверка цитат, фильтры, форматирование.
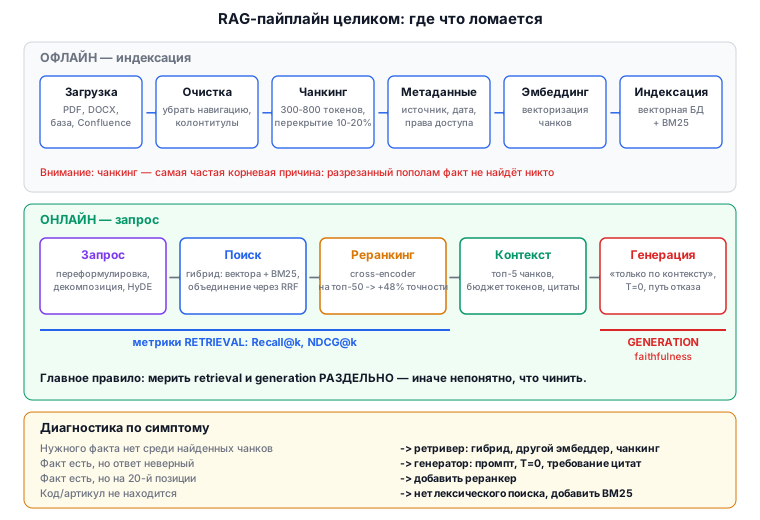
Где RAG ломается — это главный вопрос
Наивный RAG ошибается на этапе поиска примерно в 40% случаев. Диагностика идёт сверху вниз:
| Симптом | Где искать | Что делать |
|---|---|---|
| Нужного факта нет в найденных чанках | Ретривер. Смотреть Recall@k | Гибридный поиск, другой эмбеддер, переформулировка запроса, другой чанкинг |
| Факт есть, но ответ неверный | Генератор | Ужесточить промпт, снизить температуру, добавить требование цитат |
| Факт есть, но на 20-й позиции и теряется | Ранжирование | Добавить реранкер |
| Ответ по устаревшей версии документа | Индекс | Обновление индекса, фильтр по дате, приоритет свежести |
| Нашлось похожее, но не то | Чанкинг или эмбеддер | Чанки меньше/семантичнее, дообучение эмбеддера на домене |
| Точный код/артикул не находится | Отсутствует лексический поиск | Добавить BM25 |
| Пользователь видит чужие документы | Права доступа | Фильтрация по метаданным до поиска, не после |
Ключевая мысль для собеседования: всегда меряйте retrieval и generation раздельно. Иначе вы не знаете, что чинить. Это первое, что спросит хороший интервьюер.
Гибридный поиск — обязательная часть
Плотные векторы отлично ловят смысл, но плохо — точные строки: артикулы, коды ошибок, названия моделей, редкие имена, аббревиатуры. Запрос «ошибка E-4271» вектор «размажет», а BM25 найдёт точно.
Результаты двух поисков объединяют через Reciprocal Rank Fusion: документ получает балл Σ 1/(k + позиция) по каждому списку. Достоинство — не нужно нормировать несравнимые оценки разных систем, работают только позиции.
Замеренный эффект гибрида — порядка +10 пунктов MRR и +15–30% релевантности против чисто семантического поиска. Это цифры, которые полезно назвать.
Реранкинг
Двухступенчатая схема: bi-encoder быстро достаёт 50–100 кандидатов, cross-encoder аккуратно переупорядочивает их. Даёт до +48% точности на топе. Цена — задержка порядка 50–200 мс. Практически всегда окупается.
RAG или файнтюн или длинный контекст — таблица решения
| Ситуация | Решение |
|---|---|
| Знания меняются чаще раза в месяц | RAG |
| Нужны ссылки на источник | RAG |
| Нужно разграничение доступа по документам | RAG |
| База знаний маленькая (десятки страниц) | Длинный контекст + кэширование промпта — проще RAG |
| Нужен свой стиль, тон, формат | Файнтюн (LoRA) |
| Нужно поведение и логика решений | Файнтюн |
| Нужно и то, и другое | Оба — это норма, а не компромисс |
Вопрос: Пользователи жалуются, что бот отвечает не по делу. С чего начнёте? — С разделения проблемы. Собрать 30–50 плохих кейсов, для каждого посмотреть: были ли нужные чанки среди найденных. Если не были — проблема поиска (дальше смотреть Recall@k, чанкинг, гибрид). Если были — проблема генерации (промпт, температура, порядок чанков, длина контекста). Без этого разделения любые «улучшения» — это гадание.
58. Чанкинг
Важность на собеседовании: 9/10
█████████░🔥🔥🔥 Критично. Один из самых частых уточняющих вопросов по RAG. Ждут не «режу по 500 символов», а понимания компромиссов и стратегий под тип документа.
Почему это важно. Плохой чанкинг гарантирует провал всей системы, даже если у вас лучший эмбеддер, гибридный поиск и дорогой реранкер. Чанк — это минимальная единица знания, которую система вообще способна найти. Если факт разрезан пополам, его не найдёт никто.
Компромисс размера:
- Маленькие чанки (100–300 токенов): точный поиск, мало мусора в контексте. Но теряется связь с окружением — «он» в чанке без предыдущего абзаца бессмысленно.
- Большие чанки (1000+ токенов): контекст сохранён. Но эмбеддинг «размазывается» по нескольким темам, и поиск становится неточным — модель получает «суп из тем».
Практический ориентир: 300–800 токенов с перекрытием 10–20%. Перекрытие нужно, чтобы факт на границе не потерялся.
Стратегии:
| Стратегия | Как | Когда |
|---|---|---|
| Фиксированная длина | По N символов/токенов с перекрытием | Бейзлайн, однородный текст |
| Рекурсивная | Пробует делить по абзацам → предложениям → словам, пока не влезет | Дефолт для большинства задач |
| По структуре документа | По заголовкам, разделам, пунктам | Документация, регламенты, книги — обычно лучший вариант |
| Семантическая | Режет там, где меняется смысл (по расстоянию между эмбеддингами соседних предложений) | Неструктурированный текст; дороже |
| По элементам | Таблица — отдельный чанк, код — отдельный | Смешанные документы, техдокументация |
| Родитель-потомок | Ищем по маленьким чанкам, в контекст отдаём родительский большой | Отличный компромисс, часто лучшее решение |
| Late chunking | Сначала прогоняем весь документ через модель, потом режем эмбеддинги | Сохраняет дальний контекст, требует модели с длинным окном |
Приёмы, которые заметно поднимают качество:
- Contextual retrieval: к каждому чанку LLM дописывает 1–2 предложения контекста («Этот фрагмент из раздела о тарифах для юрлиц, речь о комиссии за переводы»). Дорого на индексации, но сильно повышает попадаемость.
- Сохранять заголовки разделов в тексте чанка — дешёвая версия того же самого.
- Таблицы не резать — либо чанк целиком, либо преобразовать в текстовое описание.
- Метаданные в индекс: дата, раздел, источник, права.
Вопрос: Как выбрать размер чанка для своих документов? — Экспериментально, на своём eval-наборе. Собрать 50–100 вопросов с известными правильными фрагментами, перебрать несколько конфигураций (размер × перекрытие × стратегия) и сравнить Recall@k ретривера — именно его, а не качество финального ответа, потому что так вы изолируете эффект чанкинга. Универсального числа нет: у регламента с чёткой структурой и у стенограмм звонков оптимум разный.
Часть 12 из 17 конспекта для подготовки к собеседованиям на NLP/LLM-разработчика. Остальные части — в разделе «Собесы».
Оставить отзыв
Комментарии
Загрузка комментариев...
★ Оставить отзыв