Темы 51–55: prefill и decode, KV-кэш, квантизация, LoRA и QLoRA, длинный контекст, эмбеддинги и реранкеры.
51. KV-кэш и как устроен инференс
Важность на собеседовании: 9/10
█████████░🔥🔥🔥 Критично для 2026. «Почему инференс LLM дорогой» и «что такое KV-кэш» — вопросы почти обязательные. Копают глубоко: фазы prefill/decode, формула размера кэша, continuous batching.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Prefill vs decode, compute- vs memory-bound | 10/10 |
| Что такое KV-кэш и зачем | 10/10 |
| Формула размера кэша | 9/10 |
| Continuous batching | 8/10 |
| Prefix caching | 8/10 |
| PagedAttention | 7/10 |
| Speculative decoding | 7/10 |
Две фазы генерации — надо знать разницу назубок:
| Prefill | Decode | |
|---|---|---|
| Что делает | Обрабатывает весь промпт целиком | Генерирует ответ по одному токену |
| Параллелизуется? | Да, все токены сразу | Нет, каждый токен зависит от предыдущего |
| Упирается в | Вычисления (compute-bound) | Скорость памяти (memory-bound) |
| Метрика | TTFT — время до первого токена | TPOT — время на каждый следующий токен |
Почему decode упирается в память, а не в вычисления. На каждый новый токен нужно прочитать все веса модели из памяти видеокарты, но полезной работы при этом делается всего на один токен. Считать нечего, а читать надо много — ядра простаивают. Именно поэтому батчинг так важен: при большом батче те же прочитанные веса используются сразу для многих запросов.
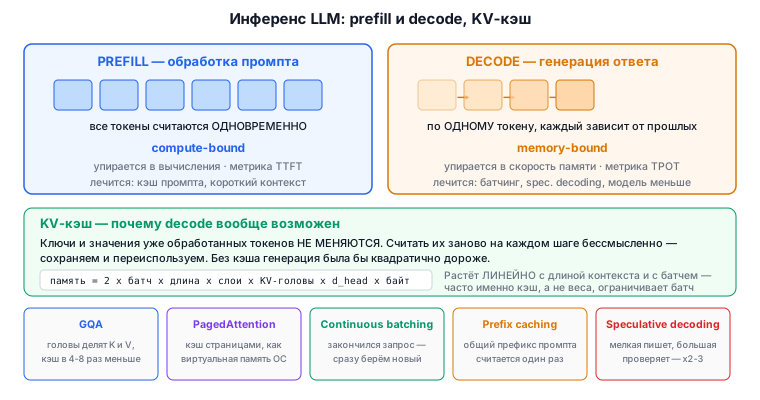
KV-кэш. При генерации токена N внимание считается по всем предыдущим токенам. Их ключи (K) и значения (V) не меняются — зачем считать их заново на каждом шаге? Сохраняем и переиспользуем. Без кэша генерация была бы квадратично дороже.
Размер кэша:
память ≈ 2 × батч × длина × число_слоёв × число_KV_голов × размер_головы × байт_на_число
Двойка — потому что храним и K, и V. Главное следствие: кэш растёт линейно с длиной контекста и с размером батча. Именно он, а не веса, обычно ограничивает, сколько запросов вы поместите на карту. Отсюда мотивация GQA (уменьшает число KV-голов) и квантизации кэша.
PagedAttention (vLLM). Проблема: под каждый запрос выделяли кэш «с запасом» на максимальную длину — память фрагментировалась и тратилась впустую. Решение подсмотрено у операционных систем: кэш бьётся на страницы фиксированного размера, физические блоки выделяются по мере надобности, логически запрос видит непрерывное пространство. Результат — кратный рост числа одновременных запросов.
Continuous batching. Обычный батчинг: собрали пачку запросов, прогнали, вернули. Плохо, потому что короткие запросы ждут длинных, а видеокарта простаивает. Continuous batching работает на уровне отдельных шагов генерации: закончившийся запрос сразу убирается из батча, на его место тут же встаёт новый. Это главный источник роста пропускной способности в vLLM и подобных движках.
Prefix caching. Если у всех запросов общее начало (длинный системный промпт, few-shot примеры), его KV-кэш считается один раз и переиспользуется. Резко снижает TTFT и стоимость. Отсюда правило: стабильную часть промпта держите в начале, изменяющуюся — в конце.
Speculative decoding. Маленькая быстрая модель («драфт») генерирует несколько токенов вперёд, большая модель проверяет их все за один проход. Совпавший префикс принимается целиком. Даёт ускорение в 2–3 раза, если модели достаточно согласованы. Качество не страдает — процедура проверки построена так, что итоговое распределение совпадает с распределением большой модели.
Вопрос: Чат-бот отвечает медленно. Что смотреть? — Разделить TTFT и TPOT. Большой TTFT — проблема в prefill: слишком длинный промпт, нет prefix caching, очередь на входе. Большой TPOT — проблема в decode: модель слишком большая для этого железа, батч плохо собирается, кэш не помещается и вытесняется. Плюс: включён ли стриминг — он не ускоряет, но воспринимаемая задержка падает радикально.
52. Квантизация
Важность на собеседовании: 8/10
████████░░🔥🔥 Часто. Практический вопрос «сколько нужно видеопамяти» задают регулярно, и умение посчитать в уме сильно поднимает оценку. Форматы (GPTQ/AWQ/GGUF/FP8) — знать названия и когда что.
Идея. Хранить веса не в 16 битах, а в 8 или 4. Память падает кратно, скорость обычно растёт, качество немного проседает.
Как считать память (это и просят на собесе):
память на веса ≈ число параметров × байт на параметр
- FP16/BF16 — 2 байта: модель 7B ≈ 14 ГБ
- INT8 — 1 байт: 7B ≈ 7 ГБ
- INT4 — 0.5 байта: 7B ≈ 3.5 ГБ
Плюс сверху 20–30% на KV-кэш, активации и накладные расходы. То есть 7B в 4 битах комфортно живёт на карте с 8 ГБ, а 70B в 4 битах — около 35–40 ГБ, то есть влезает в одну A100/H100 80 ГБ вместе с кэшем.
Форматы:
- GPTQ — послойная квантизация с калибровкой на небольшом наборе данных. Ветеран, широко поддержан.
- AWQ — умнее: определяет по активациям, какие веса важны для качества, и оставляет их точнее. Обычно лучше GPTQ на том же размере. Предпочтительный INT4 для серверных карт.
- GGUF (llama.cpp, Ollama) — для локального запуска, умеет делить модель между GPU и CPU. Уровни от Q2 до Q8; практическая рекомендация — Q5_K_M или Q6_K дают качество, близкое к исходному, а Q2 уже заметно деградирует.
- FP8 — 8-битный плавающий формат, поддержан аппаратно на H100 и новее. Качество почти как FP16 при вдвое меньшей памяти. Хороший дефолт на современных серверах.
- Bitsandbytes NF4 — используется в QLoRA (тема 53).
Что можно квантовать: только веса (weight-only — самый популярный и безопасный вариант, активации остаются в fp16), веса и активации (сложнее, нужна калибровка), и отдельно KV-кэш (даёт больше места под контекст и батч).
Важная оговорка. Снижение точности не всегда ускоряет. Скорость зависит от того, поддерживает ли конкретная видеокарта арифметику в этом формате аппаратно и есть ли под него оптимизированные ядра. Экономия памяти будет всегда, а вот ускорение — не гарантировано. Проговорить это — признак практического опыта.
Вопрос: Влезет ли LLaMA-70B на одну карту 24 ГБ? — В FP16 нет (нужно ~140 ГБ). В INT4 веса займут ~35 ГБ — тоже нет. Варианты: взять модель поменьше (лучший выбор), разложить на несколько карт, использовать GGUF с выгрузкой части слоёв в оперативную память (будет медленно), либо арендовать карту побольше. Честный ответ «на 24 ГБ 70B нормально не поедет» лучше попытки натянуть.
53. LoRA и QLoRA
Важность на собеседовании: 9/10
█████████░🔥🔥🔥 Критично. Один из самых частых практических вопросов на LLM-собесе. Ждут не только «что это», но и суждение: когда файнтюнить не надо. Копают глубоко: rank, alpha, целевые модули.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Когда файнтюн НЕ нужен (RAG вместо него) | 10/10 |
| Механика LoRA: ΔW = B·A | 9/10 |
| Параметры r, alpha, target_modules | 8/10 |
| QLoRA и 4-битная база | 8/10 |
| Катастрофическое забывание | 7/10 |
| Много адаптеров поверх одной базы | 6/10 |
Проблема. Полный файнтюн модели 7B требует памяти не только под веса (14 ГБ), но и под градиенты (ещё 14) и состояния оптимизатора Adam (ещё ~56 ГБ в fp32). Итого под сотню гигабайт ради одной задачи.
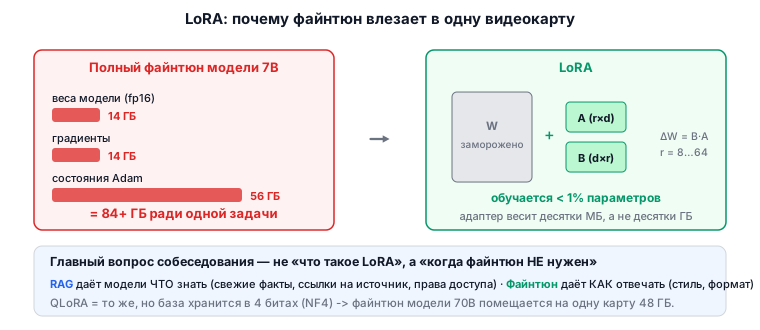
LoRA (Low-Rank Adaptation). Замораживаем всю модель. Рядом с выбранными слоями добавляем две маленькие матрицы: ΔW = B·A, где A имеет размер r×d, а B — d×r, и r очень маленькое (8, 16, 32). Обучаем только их. Обучаемых параметров становится меньше 1% от исходных.
Почему это работает: гипотеза в том, что адаптация модели к новой задаче — «низкоранговая», то есть требует изменений в небольшом числе направлений, а не переписывания всей матрицы.
Ключевые параметры:
r(rank) — «ёмкость» адаптера. 8–16 хватает для стиля и формата; 32–64 нужны, если задача действительно новая и сложная. Больше — не всегда лучше, начинается переобучение.alpha— масштаб вклада адаптера, эффективная сила равнаalpha/r. Практика:alpha = 2r(например, r=16, alpha=32).target_modules— к каким слоям цеплять. Раньше только кq_projиv_proj; сейчас практика показывает, что лучше ко всем линейным слоям, включая FFN.dropout— 0.05–0.1 для регуляризации.
Плюсы, которые стоит назвать: обучение на одной потребительской карте; адаптер весит десятки мегабайт вместо десятков гигабайт; можно держать много адаптеров под разные задачи и переключать их на лету поверх одной базовой модели; при желании адаптер вливается в базовые веса (merge), и тогда на инференсе нет никакого замедления.
QLoRA — то же самое, но базовая модель хранится в 4 битах (формат NF4), а адаптеры обучаются в более высокой точности. Плюс два трюка: двойная квантизация (квантуются даже константы квантизации) и paged optimizers (выгрузка состояний оптимизатора в оперативную память при пиках). Итог: файнтюн модели 70B помещается на одну карту 48 ГБ.
Когда файнтюнить, а когда нет — это и есть главный вопрос:
| Нужно | Решение |
|---|---|
| Модель должна знать свежие/внутренние факты | RAG, не файнтюн |
| Нужен свой стиль, тон, формат ответа | LoRA |
| Нужен строго определённый формат вывода | Structured output, не файнтюн |
| Нужна специфичная терминология домена | RAG + few-shot; LoRA если не хватило |
| Нужно поведение/логика принятия решений | LoRA/SFT |
| Нужно сделать модель дешевле и быстрее | Дистилляция в маленькую модель |
Формула для запоминания: RAG даёт модели что знать, файнтюн — как отвечать.
Катастрофическое забывание. Дообучаясь на узкой задаче, модель теряет общие способности. Лечится малым learning rate, малым числом эпох (1–3), подмешиванием общих данных и — собственно — самим LoRA, потому что базовые веса заморожены.
Вопрос: Бизнес хочет, чтобы бот отвечал по свежей внутренней документации. Файнтюнить? — Нет. Документация меняется, а файнтюн — это фиксация знаний в весах на момент обучения: при каждом обновлении придётся переобучать, и всё равно нет гарантии, что модель воспроизведёт факт точно, и нельзя дать ссылку на источник. Правильно — RAG. Файнтюн уместен рядом с ним, если нужно приучить модель к корпоративному стилю ответа или к строгому следованию регламенту.
54. Длинный контекст
Важность на собеседовании: 7/10
███████░░░🔥🔥 Часто, и заметно вырос в 2026. Любимый вопрос: «зачем RAG, если контекст миллион токенов». Хороший ответ требует знать про деградацию качества на длине.
Почему длинный контекст дорог. Внимание квадратично: удвоение длины даёт четырёхкратный рост вычислений. Плюс KV-кэш растёт линейно и съедает память.
Как его получают:
- Эффективные реализации внимания (FlashAttention) — снимают память, но не квадратичность вычислений.
- Разреженное/оконное внимание (Longformer, BigBird) — каждый токен смотрит не на всех, а на окно плюс несколько «глобальных» токенов.
- Расширение RoPE после обучения (position interpolation, NTK-aware, YaRN) — самый ходовой путь.
- Альтернативные архитектуры (Mamba и state-space модели) — линейная сложность, но пока проигрывают на задачах точного извлечения.
Главный факт 2026 года — «context rot». Заявленная длина контекста и полезная длина — разные вещи. Модель может проходить синтетический тест «найди иголку в стоге сена» с точностью выше 99%, но на реальных многошаговых задачах качество заметно падает уже к 32k, а между 200k и 1M у большинства моделей просадка на десятки процентных пунктов. Плюс известный эффект «lost in the middle»: факты в середине длинного контекста находятся хуже, чем в начале и в конце.
Практический вывод, который и хотят услышать: длинный контекст не отменил RAG. Он полезен, когда база знаний маленькая и помещается целиком (тогда плюс кэширование промпта — и это дешевле и проще RAG). Но когда документов много, RAG выигрывает по всем статьям: дешевле (не платим за 500k токенов на каждый запрос), быстрее, точнее (модель получает 5 релевантных кусков вместо стога сена), даёт ссылки на источники и позволяет разграничить права доступа. Замеры на моделях среднего размера показывают преимущество RAG над «закинуть всё в контекст» даже при окне 128k.
Вопрос: Как проверить, что модель реально держит заявленный контекст? — Не синтетическим «needle in a haystack» — он слишком лёгкий и завышает оценку. Нужны многошаговые задачи с несколькими «иголками», разбросанными по разным позициям, и замер качества как функции от длины входа и позиции факта. И обязательно на своих данных, а не на публичном бенчмарке.
55. Эмбеддинги и реранкеры
Важность на собеседовании: 10/10
██████████🔥🔥🔥 Критично для LLM-приложений. Это фундамент RAG, спрашивают всегда. Обязателен вопрос про bi-encoder vs cross-encoder — он проверяет, понимаете ли вы, почему нельзя просто «взять модель поточнее».
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Bi-encoder vs cross-encoder | 10/10 |
| Двухступенчатая схема поиска | 10/10 |
| Как выбирать модель эмбеддингов | 9/10 |
| Контрастивное обучение и hard negatives | 7/10 |
| Косинус vs скалярное произведение | 7/10 |
| Переиндексация при смене модели | 7/10 |
Эмбеддинг — вектор фиксированной длины, представляющий смысл текста. Похожие по смыслу тексты дают близкие векторы.
Как их обучают. Контрастивно: берут пары «похожие» (вопрос и правильный ответ) и «непохожие», и учат модель сближать первые и разводить вторые. Отрицательные примеры берут двумя способами: in-batch negatives (все остальные примеры в батче) и hard negatives — специально подобранные тексты, которые похожи, но не подходят. Именно hard negatives дают основной прирост качества. Тонкость: часть «отрицательных» на самом деле релевантна, просто не размечена — это шумит обучение.
Bi-encoder против cross-encoder — ключевое различие:
| Bi-encoder | Cross-encoder | |
|---|---|---|
| Как считает | Кодирует запрос и документ отдельно, сравнивает векторы | Подаёт запрос и документ вместе в модель, выдаёт оценку |
| Скорость | Очень быстро: документы закодированы заранее | Очень медленно: нужен прогон на каждую пару |
| Качество | Хорошее | Заметно лучше |
| Можно индексировать? | Да | Нет |
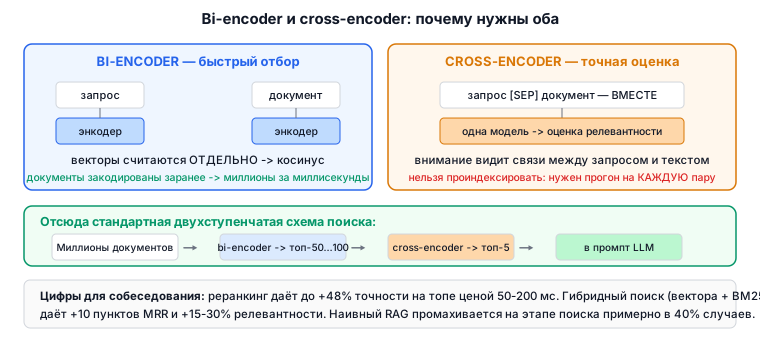
Отсюда стандартная двухступенчатая схема: bi-encoder быстро достаёт 50–100 кандидатов из миллионов документов, cross-encoder (реранкер) аккуратно переупорядочивает эти 50–100. Прирост точности от реранкинга измеряют в десятках процентов — это одна из самых окупаемых оптимизаций RAG.
Что использовать в 2026:
- Открытые многоязычные: BGE-M3 (умеет и плотные, и разреженные представления, длинный контекст), multilingual-E5, Qwen3-Embedding, для русского — модели вроде FRIDA и ru-адаптации E5.
- Через API: OpenAI text-embedding-3, Voyage, Cohere Embed (сильны на многоязычии).
- Реранкеры: bge-reranker-v2-m3, Qwen3-Reranker, Cohere Rerank.
Как выбирать (не «по верхушке MTEB»):
- Смотреть не общий средний балл MTEB, а подраздел Retrieval и, если есть, русскоязычный ruMTEB.
- Проверять на своих данных — доменная специфика решает больше, чем позиция в лидерборде.
- Учитывать размерность вектора (влияет на стоимость хранения и скорость поиска) и максимальную длину входа.
- Помнить: смена модели эмбеддингов требует переиндексации всей базы. Это дорогая операция, выбирайте один раз и осознанно.
Matryoshka-эмбеддинги — модель обучена так, что первые k координат вектора уже сами по себе осмысленны. Можно хранить укороченные векторы и экономить память почти без потери качества. Приятный факт для собеседования.
Вопрос: Поиск по эмбеддингам находит тематически похожее, но не то, что нужно. Что делать? — Сначала проверить, не лексическая ли это задача (артикулы, коды, имена) — тогда нужен гибрид с BM25. Потом добавить реранкер. Потом посмотреть на чанкинг — возможно, куски слишком большие и смысл размывается. И только потом думать о дообучении эмбеддера на своём домене контрастивно.
Часть 11 из 17 конспекта для подготовки к собеседованиям на NLP/LLM-разработчика. Остальные части — в разделе «Собесы».
Оставить отзыв
Комментарии
Загрузка комментариев...
★ Оставить отзыв