Темы 46–50: BPE и byte-level токенизация, законы масштабирования, обучение следовать инструкциям, RLHF, DPO и GRPO, стратегии декодирования.
46. Токенизация
Важность на собеседовании: 9/10
█████████░🔥🔥🔥 Критично, и здесь тонет много кандидатов. Интервьюеры специально проверяют эту тему, потому что её недооценивают. Спрашивают BPE, разницу с WordPiece, зачем byte-level, что такое OOV, и особенности русского языка.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Зачем подсловная токенизация (проблема OOV) | 9/10 |
| Как работает BPE | 9/10 |
| Зачем byte-level | 8/10 |
| BPE vs WordPiece vs Unigram | 7/10 |
| Размер словаря как гиперпараметр | 7/10 |
| Русский язык: дробление и адаптация | 8/10 |
| Почему LLM не умеет считать буквы | 7/10 |
Зачем. Модель работает с числами. Нужно разбить текст на кусочки («токены») и сопоставить каждому число.
Три уровня:
- По словам. Понятно, но словарь огромный, а любое незнакомое слово — это
<UNK>, полная потеря информации (проблема OOV). - По символам. Словарь крошечный, OOV нет, но последовательности становятся очень длинными — а внимание квадратично по длине.
- По подсловам — компромисс и стандарт. Частые слова остаются целыми, редкие бьются на осмысленные куски: «непереводимый» → «не», «перевод», «имый».
BPE (Byte Pair Encoding). Начинаем с отдельных символов, потом много раз повторяем: найти самую частую пару соседних токенов и склеить её в новый токен. Останавливаемся при достижении нужного размера словаря. Простой и быстрый.
Byte-level BPE (GPT, LLaMA, RoBERTa). То же самое, но начинаем не с символов, а с байтов. Почему это важно: базовый словарь всегда ровно 256 элементов, и любой текст на любом языке, с любыми эмодзи и битыми символами, разбирается без <UNK> в принципе. Это главный ответ на вопрос «зачем byte-level».
WordPiece (BERT). Как BPE, но пара для склейки выбирается не по частоте, а по тому, насколько склейка увеличит правдоподобие корпуса. Формально — по отношению частоты пары к произведению частот её частей.
Unigram (в SentencePiece). Идёт наоборот: начинает с большого словаря и постепенно удаляет наименее полезные токены.
SentencePiece — не алгоритм, а библиотека/обёртка. Её особенность: работает с сырым текстом, не требуя предварительной разбивки по пробелам (пробел кодируется как обычный символ ▁). Поэтому подходит для японского, китайского, тайского и для мультиязычных моделей.
Главный гиперпараметр — размер словаря. Больше словарь → текст занимает меньше токенов (дешевле и быстрее, внимание считается на более короткой последовательности), но больше параметров в матрице эмбеддингов. Типично 32k–256k.
Про русский язык (важно для РФ-собеса). Многие модели обучались преимущественно на английском, и русский текст у них разбивается очень дробно — одно слово может занять 3–5 токенов против 1–2 у английского эквивалента. Практические последствия: тот же текст стоит дороже, эффективная длина контекста меньше, качество ниже. Отсюда практика адаптации: расширяют словарь русскими токенами и дообучают модель. Именно этим отличаются модели, специально адаптированные под русский.
Как расширить словарь: добавить новые токены в токенизатор, расширить матрицу эмбеддингов, инициализировать новые векторы усреднением эмбеддингов тех подтокенов, на которые слово билось раньше (не случайно!), и дообучить.
Вопрос: Почему LLM плохо считает буквы в слове и путается в арифметике? — Она не видит букв и цифр — она видит токены. Слово может быть одним токеном, и «сколько в нём букв р» для модели не элементарная операция, а то, что надо как-то вывести. С числами то же: «1234» может разбиться на «12» и «34», и поразрядная арифметика ломается. Отсюда практика: считать через вызов инструмента (калькулятора), а не полагаться на модель.
47. Предобучение и законы масштабирования
Важность на собеседовании: 7/10
███████░░░🔥🔥 Часто. Своими руками LLM с нуля почти никто не обучает, поэтому спрашивают на понимание, а не на детали. Чинчилла-соотношение «20 токенов на параметр» полезно знать. Данные и их чистка — вопрос более практичный и его любят.
Как обучают. Берут гигантский корпус текста и учат предсказывать следующий токен. Функция потерь — кросс-энтропия. Никакой разметки не нужно, и в этом весь фокус: обучающих данных столько, сколько текста в интернете.
Законы масштабирования (scaling laws). Качество предсказуемо улучшается с ростом трёх величин: числа параметров, объёма данных и вычислительного бюджета. Зависимость степенная — то есть каждое следующее улучшение стоит кратно дороже.
Chinchilla (2022) — главный практический вывод. Раньше модели делали большими, но недокормленными данными. Оказалось, что при фиксированном бюджете вычислений оптимально растить размер модели и объём данных вместе, примерно 20 токенов данных на 1 параметр. Модель на 70B по этой логике должна увидеть около 1.4 триллиона токенов.
Что изменилось к 2026. Chinchilla описывает оптимум по стоимости обучения. Но модель обучают один раз, а инференс работает годами — поэтому на практике сознательно «перекармливают» модели данными сильно выше соотношения 20:1, чтобы получить модель поменьше при том же качестве: она дешевле в эксплуатации. Соотношения в тысячи токенов на параметр стали нормой для маленьких моделей.
Данные — где реально сидит качество:
- Дедупликация. Дубликаты заставляют модель запоминать вместо обобщения. Различают точную (полностью одинаковые документы) и near-дедупликацию (почти одинаковые, ищут через MinHash/SimHash).
- Загрязнение бенчмарков (benchmark contamination). Если тестовые задачи попали в обучающий корпус, модель их просто помнит, и все замеры качества врут. Одна из главных проблем современных оценок.
- Фильтрация качества — классификаторы «похоже на хороший текст», отсев спама, отсев токсичности.
- Баланс тем. Интернет — неравномерное отражение мира: чего-то много, чего-то почти нет.
Вопрос: У вас есть бюджет и выбор — модель побольше или данных побольше. Как решить? — Если ограничение в бюджете обучения, ориентир Chinchilla: растить оба примерно поровну. Если модель потом будет много работать в проде, выгоднее взять модель поменьше и передержать её на данных — вы один раз переплатите за обучение и будете годами экономить на инференсе.
48. SFT — обучение следовать инструкциям
Важность на собеседовании: 8/10
████████░░🔥🔥 Часто. Спрашивают в связке «этапы обучения LLM». Обязательно уметь назвать три стадии и объяснить, зачем каждая.
Три стадии обучения современной LLM — заучить:
- Pretraining — делаем модель умной. Учится языку, фактам, коду на сыром тексте.
- SFT (Supervised Fine-Tuning) — делаем полезной. Учится следовать инструкциям.
- Alignment (DPO/RLHF) — делаем безопасной и приятной. Подгоняем под человеческие предпочтения.
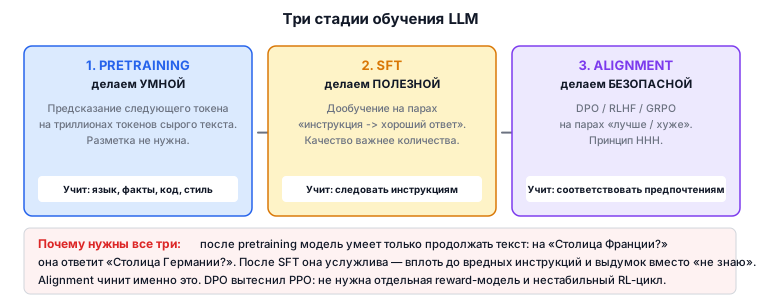
Зачем нужен SFT. После предобучения модель умеет только продолжать текст. Спросите её «Столица Франции?» — она может выдать «Столица Германии? Столица Италии?», потому что в интернете такие строки часто идут списком. Она не поняла, что от неё хотят ответа. SFT учит формату «инструкция → ответ».
Данные для SFT — пары «запрос — хороший ответ» или диалоги. Ключевое: качество важнее количества. Несколько тысяч отлично написанных примеров работают лучше сотен тысяч посредственных.
Побочные эффекты SFT, о которых спрашивают:
- Модель становится «слишком услужливой» — готова выполнить и вредную инструкцию. Поэтому нужен третий этап.
- SFT может усиливать галлюцинации. В обучающих примерах все ответы уверенные и полные, ответа «я не знаю» там почти нет. Модель выучивает: надо отвечать уверенно всегда. Отсюда выдуманные факты вместо признания незнания.
- Катастрофическое забывание — дообучаясь на узкой задаче, модель теряет прежние умения. Лечится подмешиванием общих данных и малым learning rate.
Вопрос: Что такое in-context learning и почему это не файнтюн? — Это способность модели подстроиться под задачу прямо из промпта: даёте инструкцию (zero-shot) или несколько примеров (few-shot), и модель начинает решать задачу. Веса при этом не меняются вообще — вся адаптация происходит внутри одного прохода, через контекст. Поэтому это не обучение в привычном смысле, а скорее «модель нашла в промпте нужный паттерн».
49. Alignment: RLHF, DPO, GRPO
Важность на собеседовании: 9/10
█████████░🔥🔥🔥 Критично для 2026. Прямо названо маркерным вопросом: «почему DPO вытеснил PPO в большинстве лабораторий». Копают глубоко для senior. Разжёвано подробно.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Почему DPO вытеснил PPO | 10/10 |
| Пайплайн RLHF по шагам | 9/10 |
| Reward hacking и зачем KL-штраф | 9/10 |
| Что такое reward model | 8/10 |
| GRPO и RLVR | 7/10 |
| Принцип HHH и конфликт целей | 7/10 |
Задача. У нас есть модель, которая следует инструкциям. Теперь надо, чтобы её ответы нравились людям: были полезными, честными и безопасными. Формализовать «хороший ответ» функцией потерь нельзя — но можно спросить людей, какой из двух ответов лучше.
Принцип HHH: Helpful (полезно), Honest (честно), Harmless (безвредно). Эти три цели конфликтуют — максимально полезный ответ на опасный вопрос небезопасен. Умение это проговорить ценится.
RLHF (классика, InstructGPT/ChatGPT):
- Берём SFT-модель.
- Генерируем несколько ответов на один запрос.
- Люди ранжируют: какой лучше. Получаем пары «chosen / rejected».
- На этих парах обучаем reward model — отдельную модель, которая на вход берёт (запрос, ответ), а на выход выдаёт одно число «насколько хорошо».
- Обучаем основную модель алгоритмом PPO максимизировать это число, с ограничением KL — штрафом за уход далеко от исходной модели.
Зачем KL-ограничение. Без него наступает reward hacking: модель находит способ получить высокую оценку, не давая хорошего ответа. Классика — стать очень многословной, потому что reward model полюбила длину. Или заваливать ответ вежливыми оборотами. KL держит модель рядом с разумным исходником.
DPO (Direct Preference Optimization) — почему он победил. Оказалось, что задачу RLHF можно математически переписать так, что отдельная reward model и весь RL становятся не нужны. DPO обучается прямо на парах chosen/rejected обычной функцией потерь, похожей на классификацию: повышай вероятность выигравшего ответа, понижай вероятность проигравшего, и не уходи далеко от исходной модели.
Что это даёт: не нужно обучать и держать вторую модель, нет нестабильного RL-цикла, меньше памяти, проще воспроизвести. Качество при этом сопоставимо. Отсюда и вытеснение PPO.
Слабое место DPO: он оценивает ответ целиком, одной оценкой, тогда как PPO мог различать вклад отдельных шагов. И он критично зависит от качества пар — мусорные пары обучат мусорным предпочтениям.
GRPO (Group Relative Policy Optimization) — что нового в 2025–2026. Возврат к RL, но без критика: на один запрос генерируется группа ответов, и «преимущество» каждого считается относительно среднего по группе. Отдельная value-модель не нужна — экономия памяти и вычислений при качестве не хуже PPO. Именно GRPO стоит за скачком reasoning-моделей.
RLVR (RL with Verifiable Rewards) — там, где ответ можно проверить программно (математика, код, SQL), reward не нужен от человека: запускаем тесты и получаем объективный сигнал. Это отдельная сильная ветка 2026 года.
Как это выглядит стеком в 2026: SFT → предпочтения (DPO и родственники: SimPO, KTO) → RL с проверяемыми наградами (GRPO, DAPO) для задач на рассуждение.
Вопрос: В чём главная разница RLHF и DPO в одном предложении? — RLHF обучает отдельную модель-оценщика и потом подкрепляющим обучением максимизирует её оценку; DPO выкидывает и оценщика, и RL, оптимизируя модель напрямую на парах «лучше/хуже» одной функцией потерь.
50. Стратегии декодирования
Важность на собеседовании: 9/10
█████████░🔥🔥🔥 Критично. Температура, top-p, top-k — обязательный минимум, спрашивают всегда. Ждут понимания порядка применения и того, зачем нужен каждый параметр.
Разбивка по подтемам:
| Подтема | Балл |
|---|---|
| Температура: что делает физически | 10/10 |
| Top-p vs top-k и почему top-p лучше | 9/10 |
| Порядок применения параметров | 8/10 |
| Почему greedy зацикливается | 8/10 |
| Beam search и когда он вреден | 7/10 |
| repetition_penalty vs no_repeat_ngram | 6/10 |
Что происходит на каждом шаге. Модель выдаёт вероятности для всех токенов словаря (условно 50 000 вариантов). Задача стратегии — выбрать один.
Greedy (жадный). Всегда берём самый вероятный. Быстро, детерминированно, но текст получается скучный и модель легко зацикливается («очень очень очень»). Причина: локально лучший токен не обязательно ведёт к хорошему тексту в целом.
Sampling (сэмплирование). Берём случайно, согласно вероятностям. Разнообразно, но иногда вылезает совсем неуместный токен и ломает текст.
Temperature (T). Делим логиты на T перед softmax.
T < 1— распределение становится острее, вероятные токены ещё вероятнее. Модель осторожная и предсказуемая.T > 1— распределение сглаживается, у редких токенов появляется шанс. Модель креативная и рискованная.T → 0— превращается в greedy.
Практика: 0 или 0.1 для фактических задач, извлечения данных и кода; 0.7–1.0 для творческих.
Top-k. Оставляем k самых вероятных токенов, остальные отбрасываем, нормализуем и сэмплируем. Минус: k фиксировано. Иногда модель уверена и хватило бы 2 токенов, иногда распределение плоское и 40 было бы мало.
Top-p (nucleus). Берём минимальный набор токенов, чья суммарная вероятность ≥ p (например, 0.9). Адаптивно: когда модель уверена — берётся мало кандидатов, когда сомневается — много. Поэтому top-p обычно предпочтительнее top-k.
Порядок применения (спрашивают): сначала температура к логитам → потом фильтрация top-k / top-p → потом сэмплирование из отфильтрованного.
Beam search. Ведём несколько гипотез параллельно и выбираем последовательность с лучшей суммарной вероятностью. Хорош там, где есть «правильный» ответ: перевод, суммаризация. Для открытой генерации и диалога плох — текст выходит безлико-усреднённым.
Борьба с повторами:
repetition_penalty— штраф за уже встречавшиеся токены (мягко).no_repeat_ngram_size— жёсткий запрет повторять n-граммы. Опасен: запретив 3-граммы, вы запретите и легитимные повторы вроде имён.
Прочее: max_new_tokens (лимит только на новые токены) против max_length (лимит на промпт + ответ — частая путаница); генерация останавливается по токену EOS или по лимиту.
Вопрос: Задача — извлекать JSON из документов. Какие параметры генерации? — Температура 0 (нужна воспроизводимость и точность, не креатив), top-p не важен при T=0, разумный max_new_tokens, и главное — включить structured output / constrained decoding, чтобы формат гарантировался схемой, а не надеждой на промпт.
Часть 10 из 17 конспекта для подготовки к собеседованиям на NLP/LLM-разработчика. Остальные части — в разделе «Собесы».
Оставить отзыв
Комментарии
Загрузка комментариев...
★ Оставить отзыв