В данном блоге доступно 37 постов на разные темы
План подготовки к собеседованию, финальный чек-лист и источники
Финал конспекта: планы подготовки на неделю и на месяц, метод самопроверки, обязательный практический минимум, чек-лист перед интервью и список источников. 75. План подготовки Как пользоваться этой методичкой Если у вас …
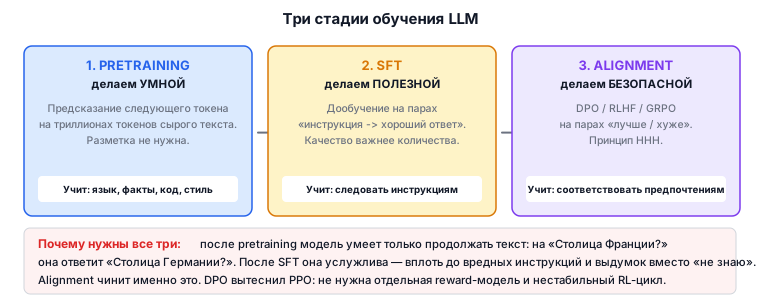
Как обучают LLM: токенизация, предобучение, SFT и alignment
Темы 46–50: BPE и byte-level токенизация, законы масштабирования, обучение следовать инструкциям, RLHF, DPO и GRPO, стратегии декодирования. 46. Токенизация Важность на собеседовании: 9/10 █████████░ 🔥🔥🔥 Критично, и здесь тонет много …
Классический NLP: TF-IDF, Word2Vec и рекуррентные сети
Темы 35–39: препроцессинг текста, мешок слов и TF-IDF, Word2Vec, GloVe и FastText, RNN, LSTM и seq2seq, классические задачи NLP и их метрики. Эта часть спрашивается реже, чем трансформеры, но полностью …
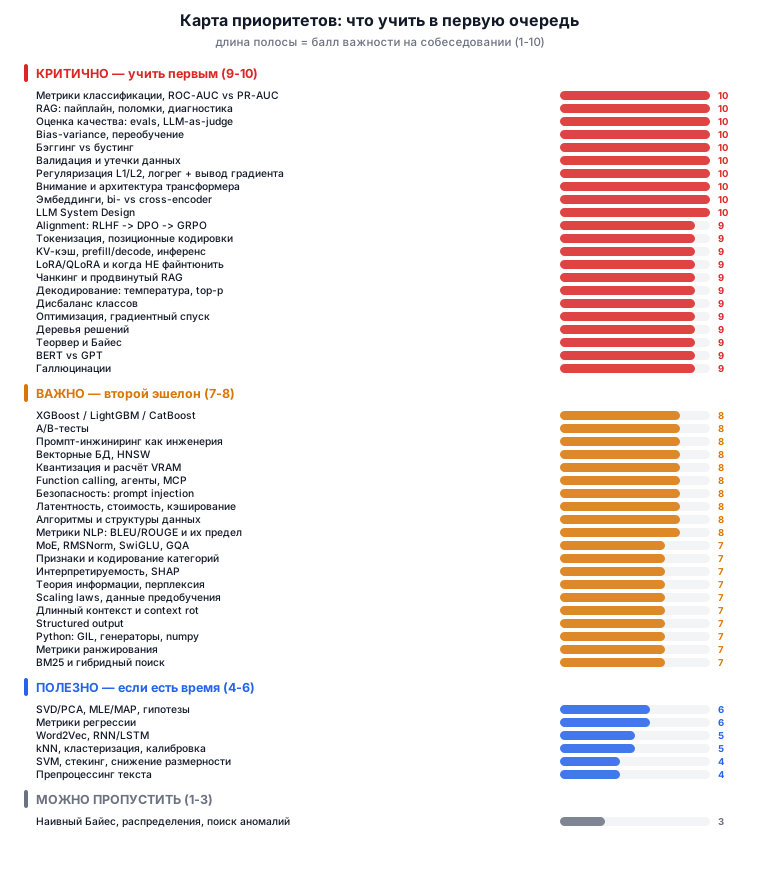
Как устроены собеседования на NLP/LLM-разработчика
Форматы и этапы интервью, обязательный минимум знаний, реальные вопросы российских компаний и техника ответа. Плюс карта приоритетов: что учить в первую очередь, а что можно пропустить. Уровень: Middle → Senior …
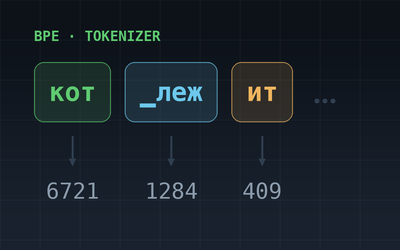
Токенизация в больших языковых моделях: как текст становится математикой
Токенизация — это процесс преобразования текста в последовательность числовых идентификаторов токенов. Это логично, так как LLM можно упрощённо рассматривать как математическую функцию, а функция — это отображение пространства аргументов в …