В данном блоге доступно 37 постов на разные темы
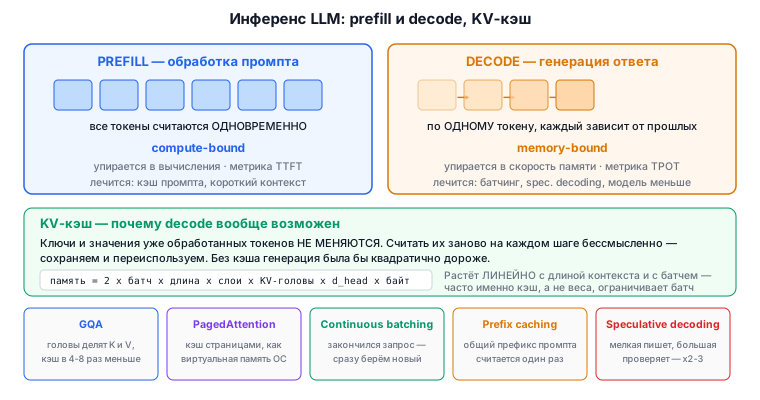
Инференс LLM: KV-кэш, квантизация, LoRA и эмбеддинги
Темы 51–55: prefill и decode, KV-кэш, квантизация, LoRA и QLoRA, длинный контекст, эмбеддинги и реранкеры. 51. KV-кэш и как устроен инференс Важность на собеседовании: 9/10 █████████░ 🔥🔥🔥 Критично для 2026. …
Классический NLP: TF-IDF, Word2Vec и рекуррентные сети
Темы 35–39: препроцессинг текста, мешок слов и TF-IDF, Word2Vec, GloVe и FastText, RNN, LSTM и seq2seq, классические задачи NLP и их метрики. Эта часть спрашивается реже, чем трансформеры, но полностью …
Классический ML: линейные модели, SVM, kNN и наивный Байес
Темы 17–22: линейная и логистическая регрессия, L1/L2-регуляризация, ядровой трюк в SVM, kNN с его метриками расстояния и наивный Байес. 17. Линейная регрессия Важность на собеседовании: 9/10 █████████░ 🔥🔥🔥 Критично. База, …
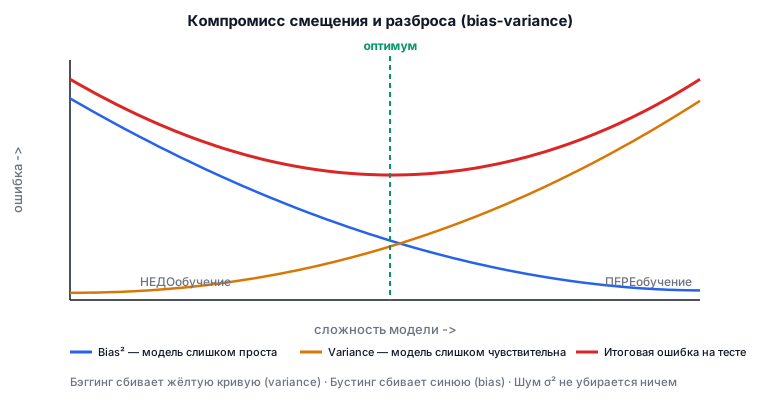
Классический ML: постановка задачи, метрики и валидация
Темы 11–16: bias–variance, метрики классификации и регрессии, ROC-AUC против PR-AUC, метрики ранжирования и кросс-валидация без утечек. Это самая опрашиваемая часть на РФ-собесах. Именно здесь режут кандидатов, которые «умеют звать LLM …
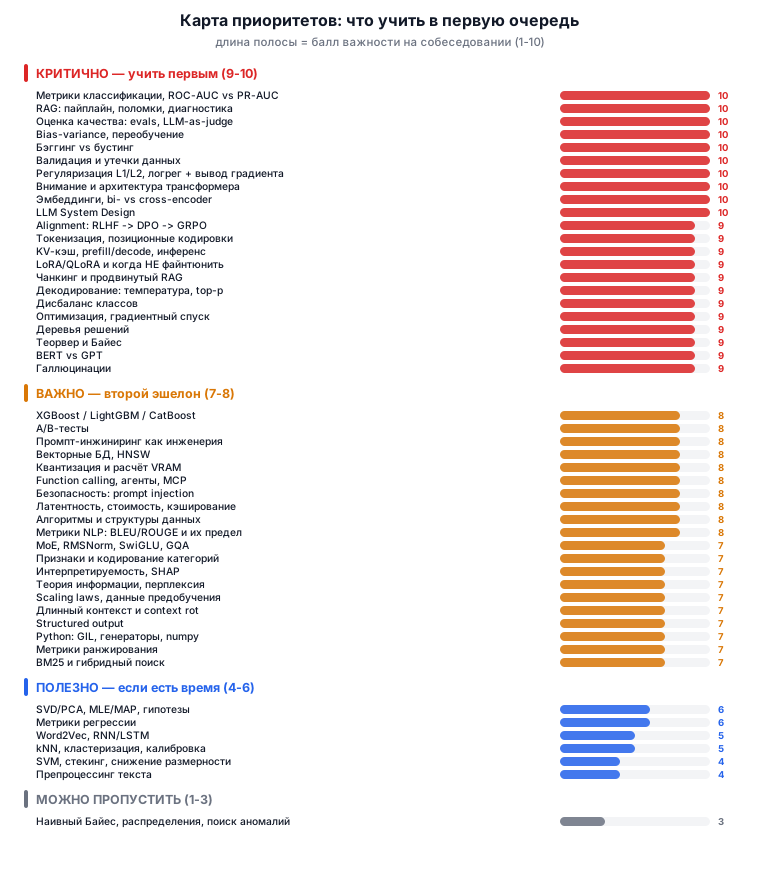
Как устроены собеседования на NLP/LLM-разработчика
Форматы и этапы интервью, обязательный минимум знаний, реальные вопросы российских компаний и техника ответа. Плюс карта приоритетов: что учить в первую очередь, а что можно пропустить. Уровень: Middle → Senior …
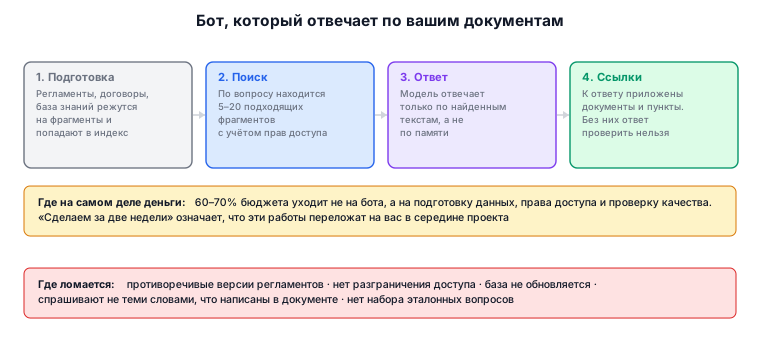
RAG: бот, который отвечает по вашим документам
«Хотим бота, который знает всё про нашу компанию и отвечает сотрудникам и клиентам» — самый частый запрос к ИИ-подрядчикам в 2026 году. Технология, которая это делает, называется RAG, и почти …