В данном блоге доступно 37 постов на разные темы
План подготовки к собеседованию, финальный чек-лист и источники
Финал конспекта: планы подготовки на неделю и на месяц, метод самопроверки, обязательный практический минимум, чек-лист перед интервью и список источников. 75. План подготовки Как пользоваться этой методичкой Если у вас …
Инженерная секция: Python, алгоритмы, ML System Design и поведенческое интервью
Темы 71–74: что спрашивают по Python, обязательный минимум алгоритмов, универсальный каркас ML System Design и как рассказывать про свой опыт. 71. Python на собеседовании Важность на собеседовании: 7/10 ███████░░░ 🔥🔥 …
LLM в проде: наблюдаемость, безопасность и System Design
Темы 67–70: трассировка, стоимость и кэширование, prompt injection и защита от него, латентность и пропускная способность, каркас для секции LLM System Design. 67. Наблюдаемость, стоимость и кэширование Важность на собеседовании: …
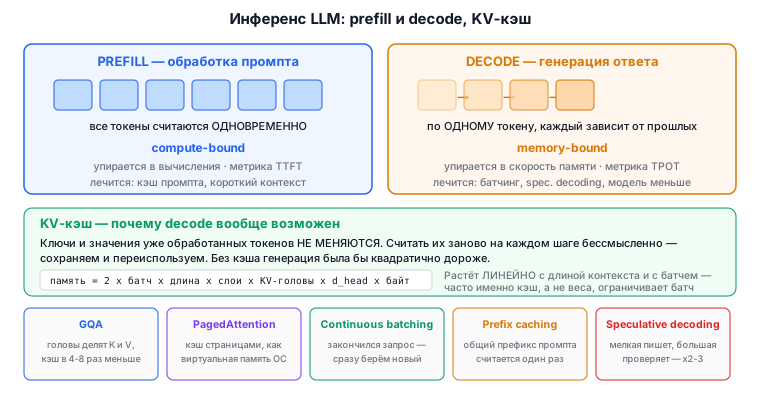
Инференс LLM: KV-кэш, квантизация, LoRA и эмбеддинги
Темы 51–55: prefill и decode, KV-кэш, квантизация, LoRA и QLoRA, длинный контекст, эмбеддинги и реранкеры. 51. KV-кэш и как устроен инференс Важность на собеседовании: 9/10 █████████░ 🔥🔥🔥 Критично для 2026. …
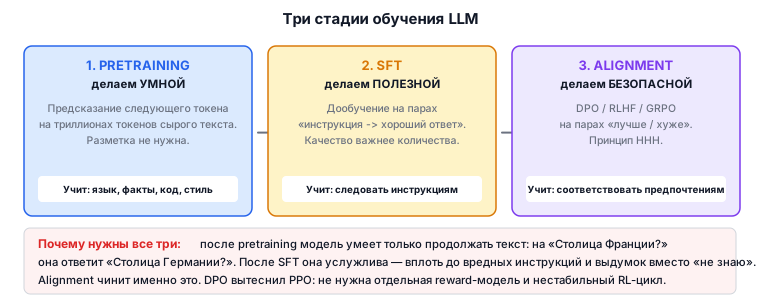
Как обучают LLM: токенизация, предобучение, SFT и alignment
Темы 46–50: BPE и byte-level токенизация, законы масштабирования, обучение следовать инструкциям, RLHF, DPO и GRPO, стратегии декодирования. 46. Токенизация Важность на собеседовании: 9/10 █████████░ 🔥🔥🔥 Критично, и здесь тонет много …
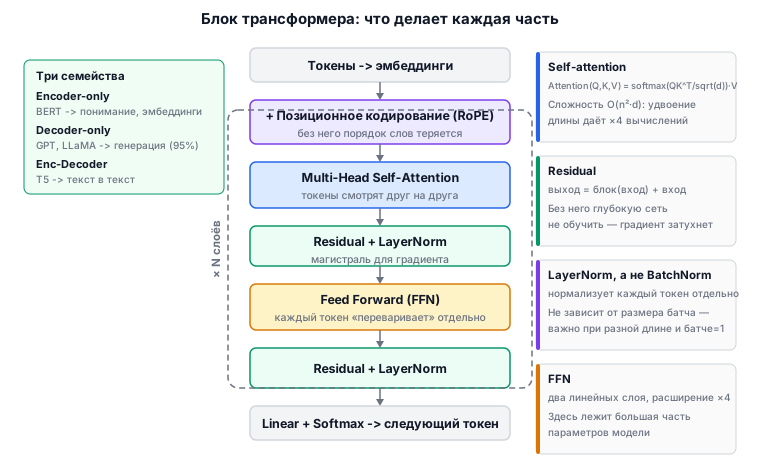
Трансформеры: архитектура, внимание и позиционные кодировки
Темы 40–45: блок трансформера, self-attention через Q, K и V, RoPE и ALiBi, MHA/MQA/GQA и FlashAttention, нормализация, активации и MoE, разница между BERT, GPT и T5. Это ядро собеседования на …