В данном блоге доступно 37 постов на разные темы
План подготовки к собеседованию, финальный чек-лист и источники
Финал конспекта: планы подготовки на неделю и на месяц, метод самопроверки, обязательный практический минимум, чек-лист перед интервью и список источников. 75. План подготовки Как пользоваться этой методичкой Если у вас …
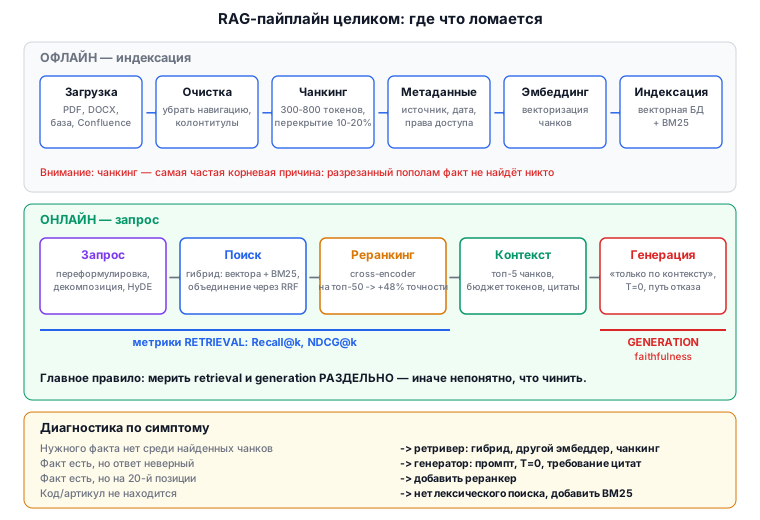
RAG с нуля: промпт-инжиниринг, базовая архитектура и чанкинг
Темы 56–58: техники промптинга, полный RAG-пайплайн и места, где он ломается, гибридный поиск, реранкинг и стратегии чанкинга. Это то, за что вас нанимают. По разборам вакансий и интервью 2026 года …
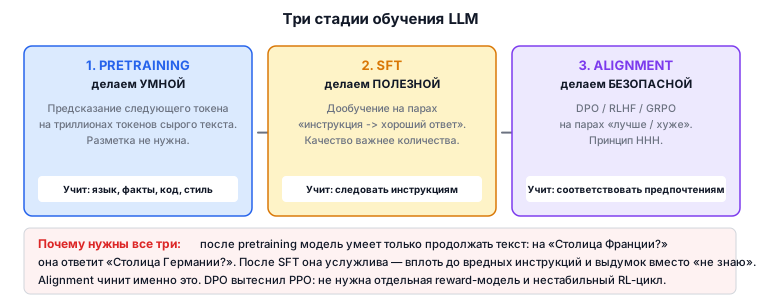
Как обучают LLM: токенизация, предобучение, SFT и alignment
Темы 46–50: BPE и byte-level токенизация, законы масштабирования, обучение следовать инструкциям, RLHF, DPO и GRPO, стратегии декодирования. 46. Токенизация Важность на собеседовании: 9/10 █████████░ 🔥🔥🔥 Критично, и здесь тонет много …
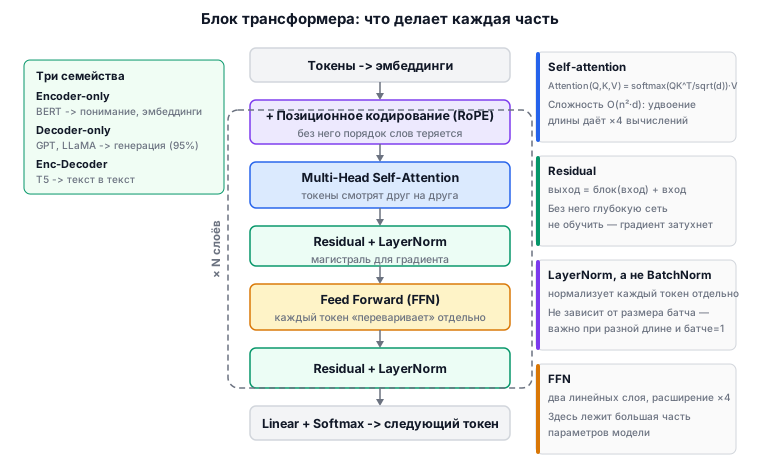
Трансформеры: архитектура, внимание и позиционные кодировки
Темы 40–45: блок трансформера, self-attention через Q, K и V, RoPE и ALiBi, MHA/MQA/GQA и FlashAttention, нормализация, активации и MoE, разница между BERT, GPT и T5. Это ядро собеседования на …
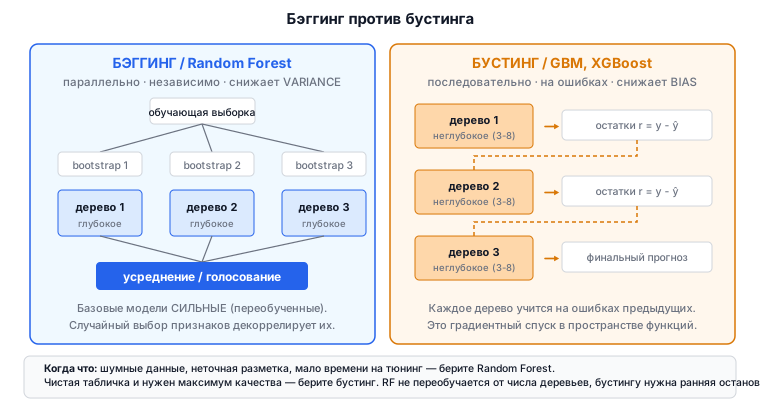
Классический ML: деревья, случайный лес и градиентный бустинг
Темы 23–27: деревья решений, бэггинг и Random Forest, AdaBoost и градиентный бустинг, чем отличаются XGBoost, LightGBM и CatBoost, стекинг и блендинг. 23. Деревья решений Важность на собеседовании: 9/10 █████████░ 🔥🔥🔥 …
Математика для собеседования: линейная алгебра, SVD и вероятность
Темы 1–5: линейная алгебра, SVD и PCA, градиенты и backprop, база теории вероятностей и распределения — тот минимум математики, который спрашивают на ML-секции. 1. Линейная алгебра для ML Важность на …